งานวิชาการ·2026
Stellar Classification
CS372 Machine Learning: ระบบจำแนกประเภทวัตถุทางดาราศาสตร์
- บทบาท
- AI/ML Engineer
- ทีม
- Solo Project
- ปี
- 2026
ตัวเลขสำคัญ
- 100,000
- รายการข้อมูล SDSS DR17
- 3
- ประเภทวัตถุที่จำแนก
- 97.85%
- Accuracy ของ XGBoost
- 0.9752
- F1-macro
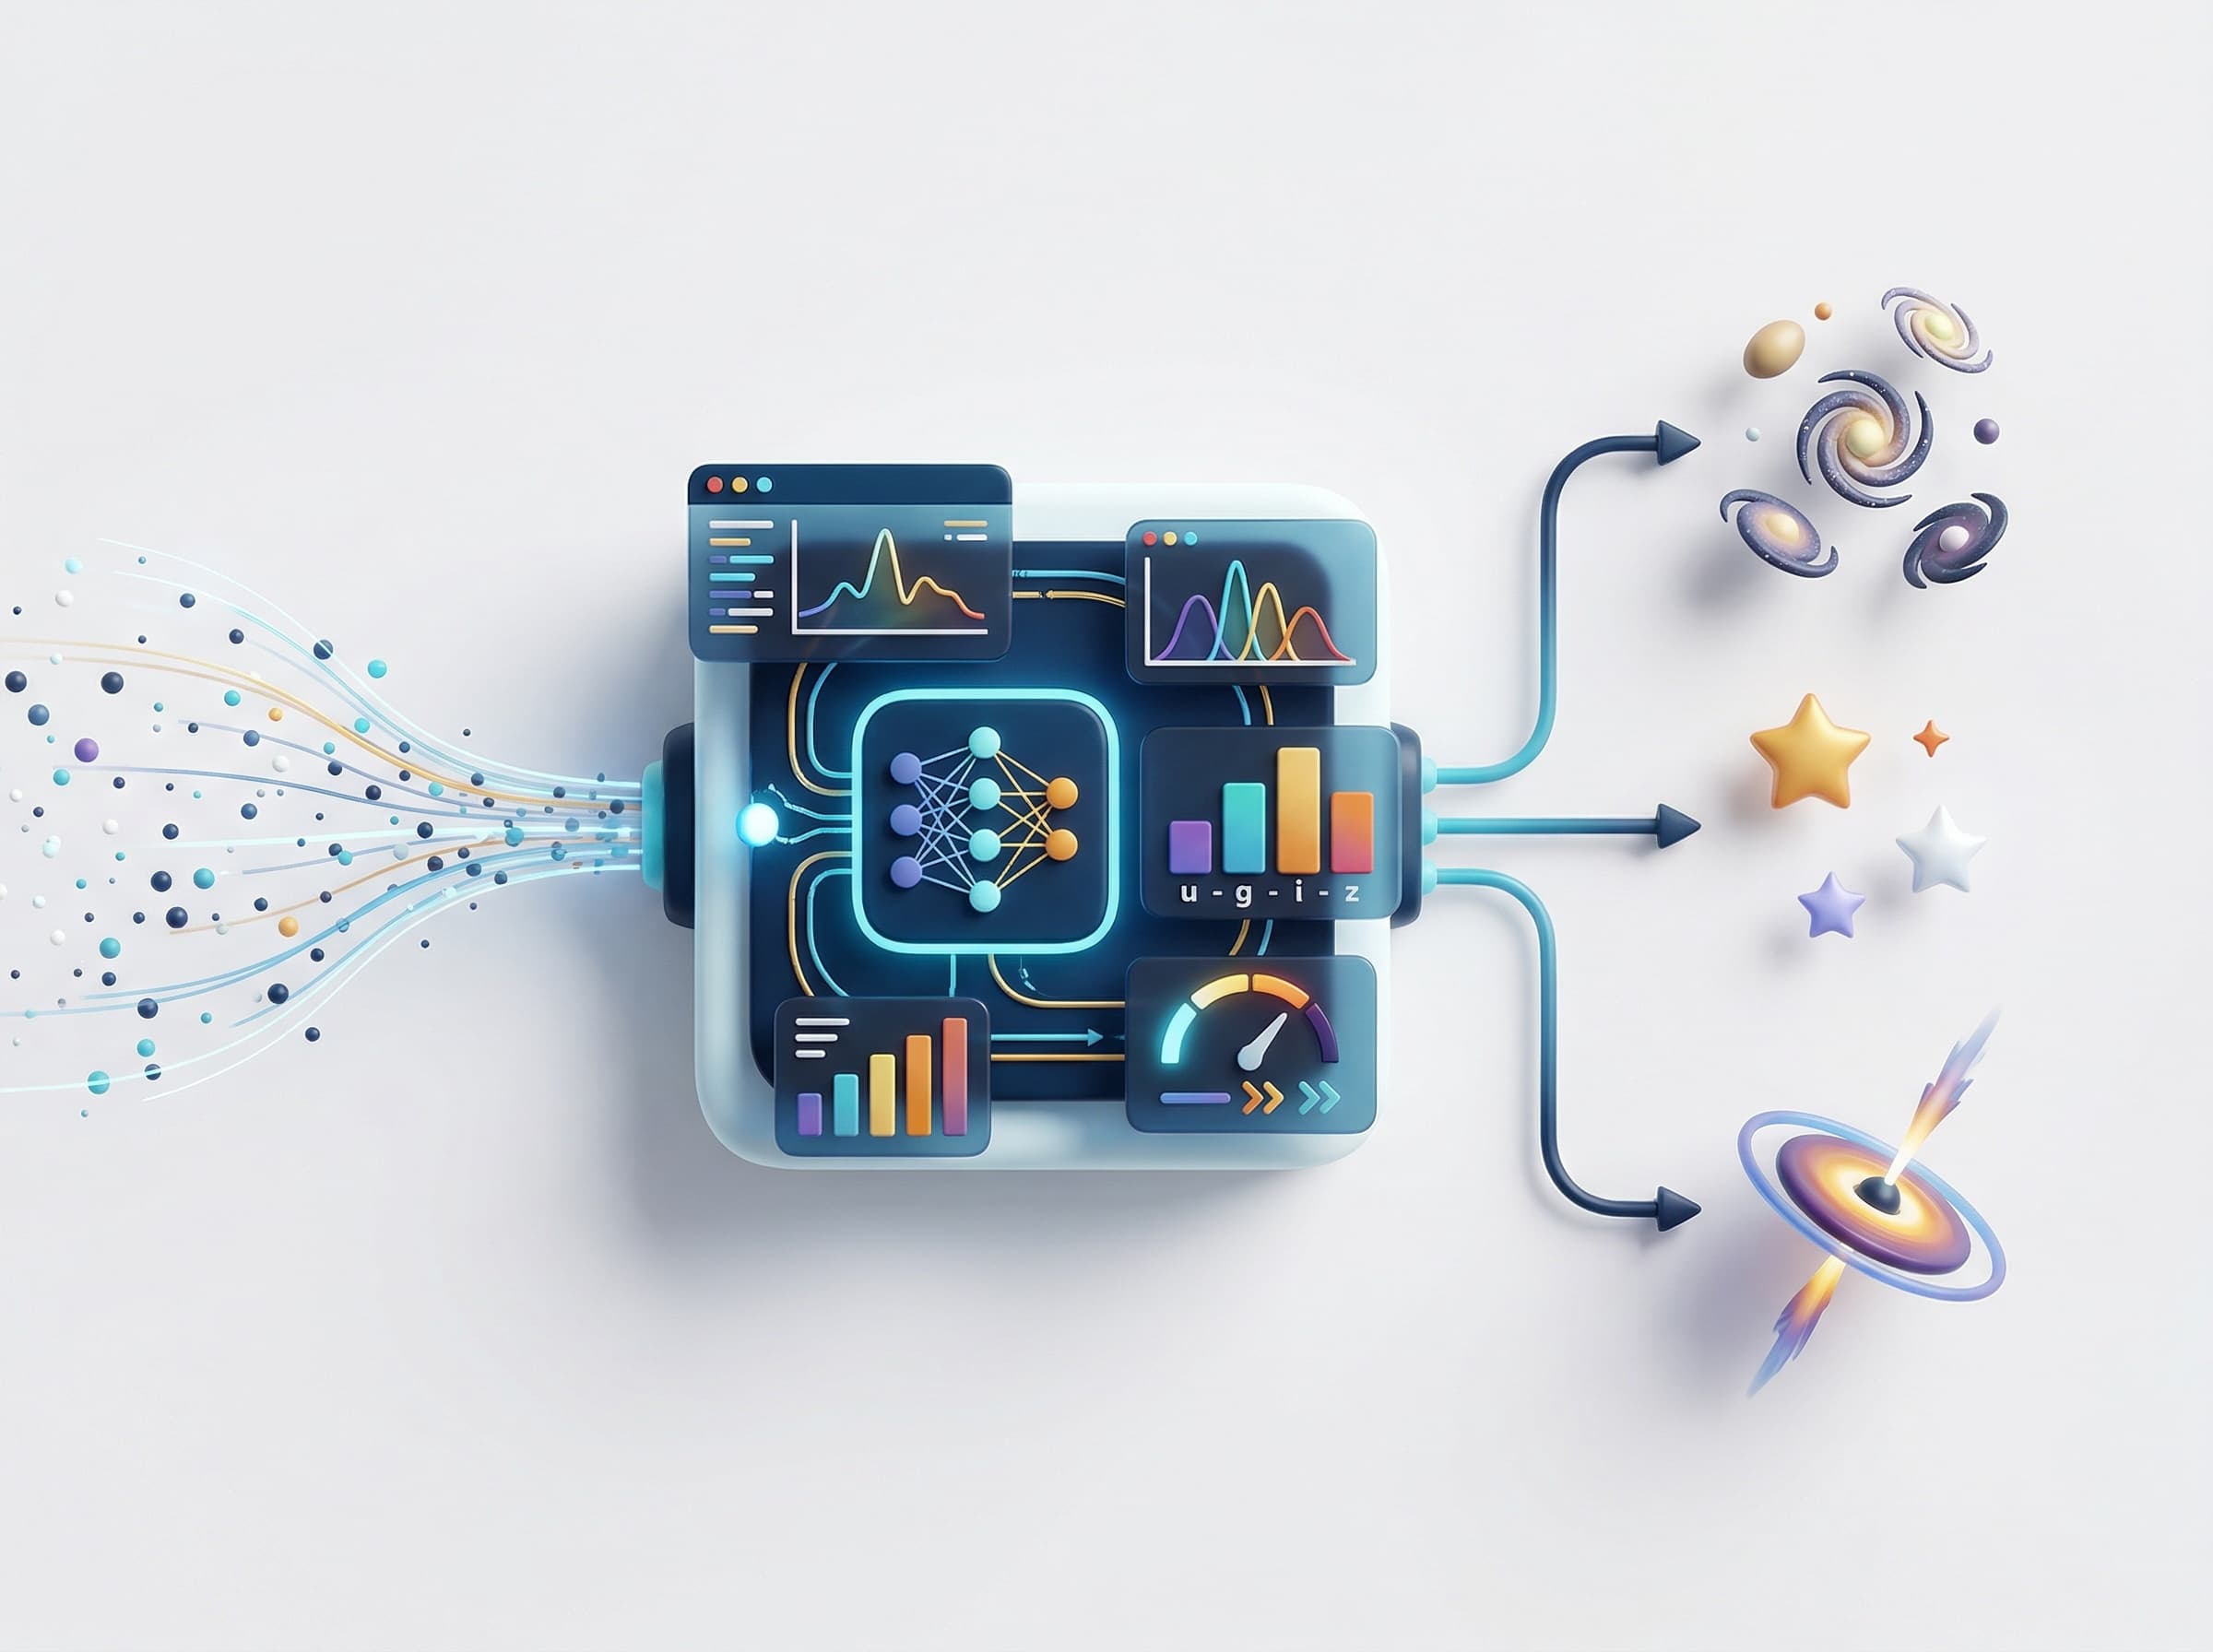
โครงงานนี้จัดทำขึ้นเพื่อศึกษาและประยุกต์ใช้เทคนิคการเรียนรู้ของเครื่อง (Machine Learning) ในการแก้ปัญหาการจำแนกประเภทวัตถุทางดาราศาสตร์ (Stellar Classification) โดยอาศัยชุดข้อมูลจากโครงการสำรวจท้องฟ้าดิจิทัลสโลน (Sloan Digital Sky Survey: SDSS) รุ่นที่ 17 (DR17) จำนวน 100,000 รายการ ระบบถูกออกแบบให้จำแนกวัตถุบนท้องฟ้าออกเป็น 3 ประเภทหลัก ได้แก่ ดาราจักร (Galaxies), ดาวฤกษ์ (Stars) และ เควซาร์ (Quasars) ผ่านการวิเคราะห์คุณลักษณะทางสเปกตรัม ข้อมูลเชิงแสงผ่านฟิลเตอร์กรองแสงย่านต่าง ๆ (u, g, r, i, z) และค่าการเลื่อนทางแดง (Redshift) เพื่อค้นหาแบบจำลองทางคณิตศาสตร์ที่แม่นยำและเหมาะสมที่สุดในการจัดการกับข้อมูลดาราศาสตร์ขนาดใหญ่ (Big Data)
โจทย์และปัญหา
- 01ปัจจุบันดาราศาสตร์ก้าวเข้าสู่ยุคข้อมูลขนาดใหญ่ (Big Data) โครงการสำรวจท้องฟ้าผลิตข้อมูลมหาศาลในระดับเทระไบต์ต่อคืน การจำแนกประเภทวัตถุเหล่านี้ด้วยมนุษย์จึงเป็นเรื่องที่เป็นไปไม่ได้ในทางปฏิบัติ
- 02วัตถุบางประเภท เช่น เควซาร์ (Quasars) ซึ่งเป็นวัตถุพลังงานสูงที่อยู่ไกลโพ้น มีลักษณะปรากฏคล้ายคลึงกับ ดาวฤกษ์ (Stars) มากเมื่อมองผ่านกล้องโทรทรรศน์ทั่วไป ทำให้การแยกแยะทำได้ยาก
- 03ต้องการระบบจำแนกประเภทอัตโนมัติที่ประมวลผลข้อมูลปริมาณมากได้อย่างรวดเร็วและแม่นยำ เพื่อลดภาระงานของนักดาราศาสตร์ และช่วยคัดกรองวัตถุเพื่อนำไปศึกษาเชิงลึกต่อไป
วิธีแก้
- 01ทำความสะอาดและเตรียมข้อมูล (Data Preprocessing) อย่างเป็นระบบ โดยแปลงค่าที่ผิดปกติทางความหมายเชิงฟิสิกส์ (Sentinel values เช่น -9999) ให้เป็น NaN และกำจัดออก รวมถึงการใช้วิธี IQR Clipping (Winsorization) เพื่อลดผลกระทบของค่า Outliers
- 02นำแนวทาง Tree-based และ Permutation Importance มาวิเคราะห์เพื่อคัดเลือกคุณลักษณะ (Feature Selection) ตัดตัวแปรที่ระบุเชิงระบบ (เช่น ID ต่าง ๆ) ที่ทำให้เกิด Data Leakage ออกไป
- 03พัฒนาและเปรียบเทียบอัลกอริทึม 3 รูปแบบ ได้แก่ K-Nearest Neighbors (KNN), XGBoost (Tree-based Ensemble) และ Neural Network (Multilayer Perceptron - MLP)
- 04ปรับจูนพารามิเตอร์ (Hyperparameter Tuning) ผ่านวิธีการ Grid Search ร่วมกับการทำ Cross Validation เพื่อค้นหาพารามิเตอร์ที่ให้ประสิทธิภาพสูงสุดและลดปัญหา Overfitting / Underfitting
ผลลัพธ์
- 01ได้แบบจำลองที่สามารถจำแนกประเภทดาราจักร ดาวฤกษ์ และเควซาร์ ได้อย่างแม่นยำสูงมาก โดยโมเดล XGBoost ให้ผลลัพธ์ดีที่สุด (Evaluation Accuracy 0.9785 และ F1-macro 0.9752)
- 02โมเดลทั้งหมดที่พัฒนาขึ้นไม่มีปัญหาสัญญาณ Overfitting อย่างมีนัยสำคัญ Generalize ไปยังข้อมูลใหม่ (Unseen Data) ได้ดี
- 03ได้ Data Pipeline ที่สมบูรณ์ ตั้งแต่กระบวนการเตรียมข้อมูล การจัดการค่าผิดปกติ ไปจนถึงการทำนายผล ซึ่งสามารถนำไปประยุกต์ใช้เป็น "ระบบคัดกรองเบื้องต้น" ใน Data Pipeline ของหอดูดาวได้จริง
ทบทวนโปรเจกต์
ความท้าทาย
- ข้อมูลไม่สมดุล (Class Imbalance) อย่างชัดเจน โดยดาราจักร (GALAXY) มีสัดส่วนเกือบ 60% ในขณะที่เควซาร์ (QSO) มีไม่ถึง 20% จึงต้องใช้ค่า F1-Score (Macro Average) มาเป็นตัวชี้วัดหลักแทน Accuracy เพื่อป้องกันโมเดลลำเอียง
- การตรวจสอบและตีความข้อมูลต้องอาศัย Domain Knowledge ทางดาราศาสตร์ เช่น ค่า Magnitude ที่ไม่ควรติดลบ หรือค่า Redshift ของดาวฤกษ์ที่ต้องมีค่าใกล้ศูนย์ การทำความสะอาดข้อมูลจึงไม่ใช่แค่กระบวนการทางสถิติแต่ต้องอิงหลักฟิสิกส์ด้วย
- การบริหารจัดการระยะเวลาและทรัพยากรคอมพิวเตอร์ในการรัน Grid Search เพื่อหาพารามิเตอร์ที่ดีที่สุดของโมเดลที่ซับซ้อนอย่าง XGBoost และ MLP บนชุดข้อมูลขนาดใหญ่ 100,000 รายการ
สิ่งที่เรียนรู้
- ได้ฝึกฝนกระบวนการวิจัยและการทำ Machine Learning แบบ End-to-End ครอบคลุมตั้งแต่การวิเคราะห์ข้อมูล (EDA), การเตรียมข้อมูล (Preprocessing), Feature Engineering, ไปจนถึงการปรับจูนและการประเมินผลโมเดล
- การเรียนรู้ธรรมชาติของอัลกอริทึมที่แตกต่างกัน ทำให้เห็นว่าโมเดลแบบ Tree-based (XGBoost) สามารถจัดการกับข้อมูลแบบตาราง (Tabular data) และเรียนรู้ความสัมพันธ์ของตัวแปรในลักษณะนี้ได้ดีเยี่ยม
- ความสำคัญของการจัดการข้อมูลที่แฝงมากับ "ค่าพิเศษ (Sentinel Values)" ซึ่งหากปล่อยผ่านไปจะทำให้ค่าเฉลี่ยและรูปทรงการกระจายตัวของข้อมูลผิดเพี้ยน และส่งผลร้ายแรงต่อความแม่นยำของโมเดล
- การประเมินประสิทธิภาพในสภาวะที่คลาสไม่สมดุล (Imbalanced Dataset) และการเปรียบเทียบคะแนนระหว่าง Cross Validation กับ Evaluation Set เพื่อยืนยันความน่าเชื่อถือของโมเดล
สนใจงานแนวนี้?
เล่าโจทย์ของคุณให้ผมฟัง ตอบกลับภายใน 24 ชั่วโมง