งานวิชาการ·2025
Miley Chatbot
CS341 Big Data: แชตบอตแนะนำสินค้า
- บทบาท
- AI/ML Engineer
- ทีม
- Group Project
- ปี
- 2025
ตัวเลขสำคัญ
- Qwen
- โมเดลภาษา
- 2
- โมดูล LLM
- Open Source ทั้งหมด
- เทคโนโลยี
- CS341 Big Data
- รายวิชา
โปรเจกต์กลุ่มในรายวิชา CS341 (Big Data) สำหรับพัฒนาแชตบอตแนะนำสินค้าโดยใช้โมเดลภาษา (LLM) และกระบวนการจัดการข้อมูลขนาดใหญ่แบบครบวงจร ระบบถูกออกแบบให้ทำงานด้วยเทคโนโลยีแบบ Open Source ทั้งหมด โดยมีขั้นตอนตั้งแต่การทำความเข้าใจข้อความลูกค้า การค้นหาสินค้าที่เกี่ยวข้องด้วย Vector Search ไปจนถึงการสรุปคำตอบให้เป็นภาษาธรรมชาติที่เหมาะสมกับบริบท
โจทย์และปัญหา
- 01ลูกค้ามักค้นหาสินค้าที่ต้องการไม่พบเมื่อข้อมูลมีจำนวนมากและหลากหลาย ทำให้การค้นหาแบบเดิมไม่ตอบโจทย์
- 02แชตบอตแบบ Rule-based มีข้อจำกัดในการทำความเข้าใจภาษาธรรมชาติและบริบทความต้องการของผู้ใช้
- 03ต้องการระบบที่เชื่อมการทำความเข้าใจข้อความเข้ากับการค้นหาข้อมูลสินค้า และสามารถสรุปผลลัพธ์ให้ตอบได้อย่างเป็นธรรมชาติ
วิธีแก้
- 01ใช้โมเดล Qwen (LLM) และเครื่องมือจาก Hugging Face เพื่อพัฒนาส่วนประมวลผลภาษาธรรมชาติ พร้อมใช้งาน GPU Cloud (Runpod.io) สำหรับการทดลอง ปรับจูน และประเมินผลโมเดลอย่างมีประสิทธิภาพ
- 02ออกแบบโมดูล LLM แยกเป็น 2 ส่วนหลัก: (1) Entity/Intent Extractor สำหรับแยกเจตนาและข้อมูลสำคัญจากข้อความลูกค้าก่อนส่งต่อไปยัง Vector Search และ (2) Composer สำหรับนำรายการสินค้าที่ได้จาก Vector Search มาประมวลผลร่วมกับบริบท แล้วจัดรูปแบบคำตอบให้เหมาะสมก่อนส่งกลับผู้ใช้
- 03ปรับจูน (Tuning) และปรับแต่ง Prompt/Instruction ให้สอดคล้องกับงานแนะนำสินค้า เพื่อลดคำตอบที่คลาดเคลื่อนและเพิ่มความสม่ำเสมอของผลลัพธ์
- 04ออกแบบ Data Pipeline เพื่อรองรับการเตรียมข้อมูล การไหลของข้อความ (Query) ไปยังโมดูลต่าง ๆ และการส่งต่อผลลัพธ์ระหว่าง LLM กับระบบค้นหาเชิงเวกเตอร์อย่างเป็นระบบ
ผลลัพธ์
- 01ระบบสามารถทำความเข้าใจข้อความลูกค้า แยก Entity/Intent ได้ก่อนเข้าสู่ขั้นตอนค้นหา ทำให้การดึงสินค้าที่เกี่ยวข้องแม่นยำและมีโครงสร้างมากขึ้น
- 02Composer สามารถสรุปและเรียบเรียงผลลัพธ์จาก Vector Search ให้เป็นคำตอบที่เป็นธรรมชาติและสอดคล้องกับบริบทการสนทนา
- 03ได้ประสบการณ์การพัฒนาโซลูชัน LLM แบบ End-to-End ตั้งแต่ Data Pipeline, การสั่งงานโมเดล, การประเมินผล และการปรับจูนเพื่อให้ได้ประสิทธิภาพที่ดีขึ้น โดยใช้ Open Source เป็นหลัก
แกลเลอรี
Main
16:9 / MD
ตัวอย่างการตอบคำถามของแชตบอต (1) - ทดสอบ
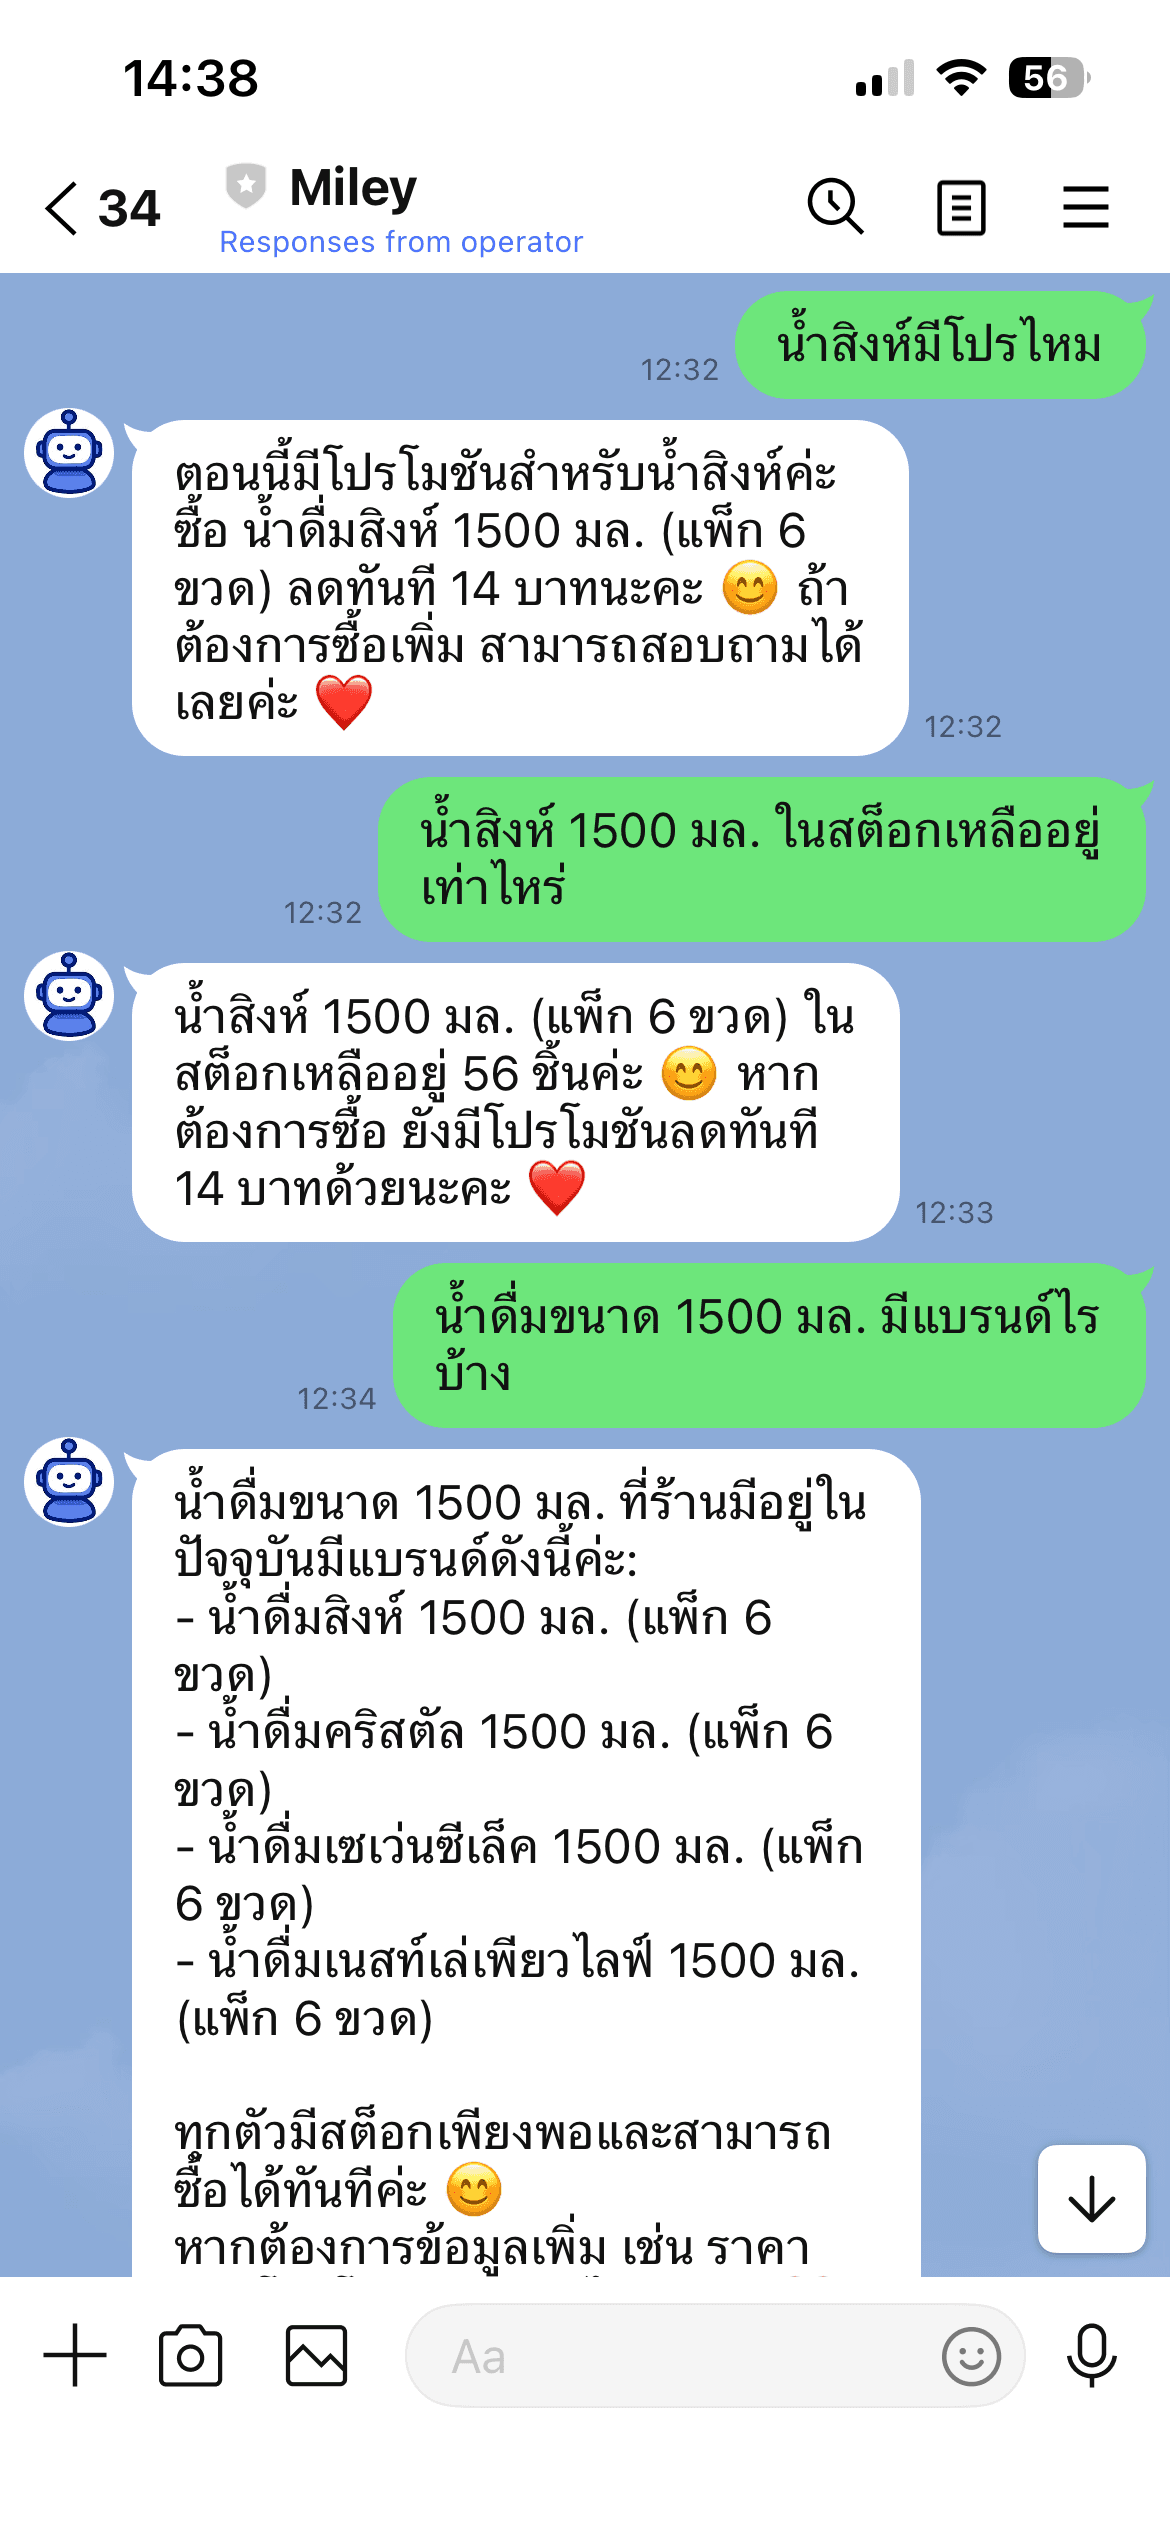
ตัวอย่างการตอบคำถามของแชตบอต (2)
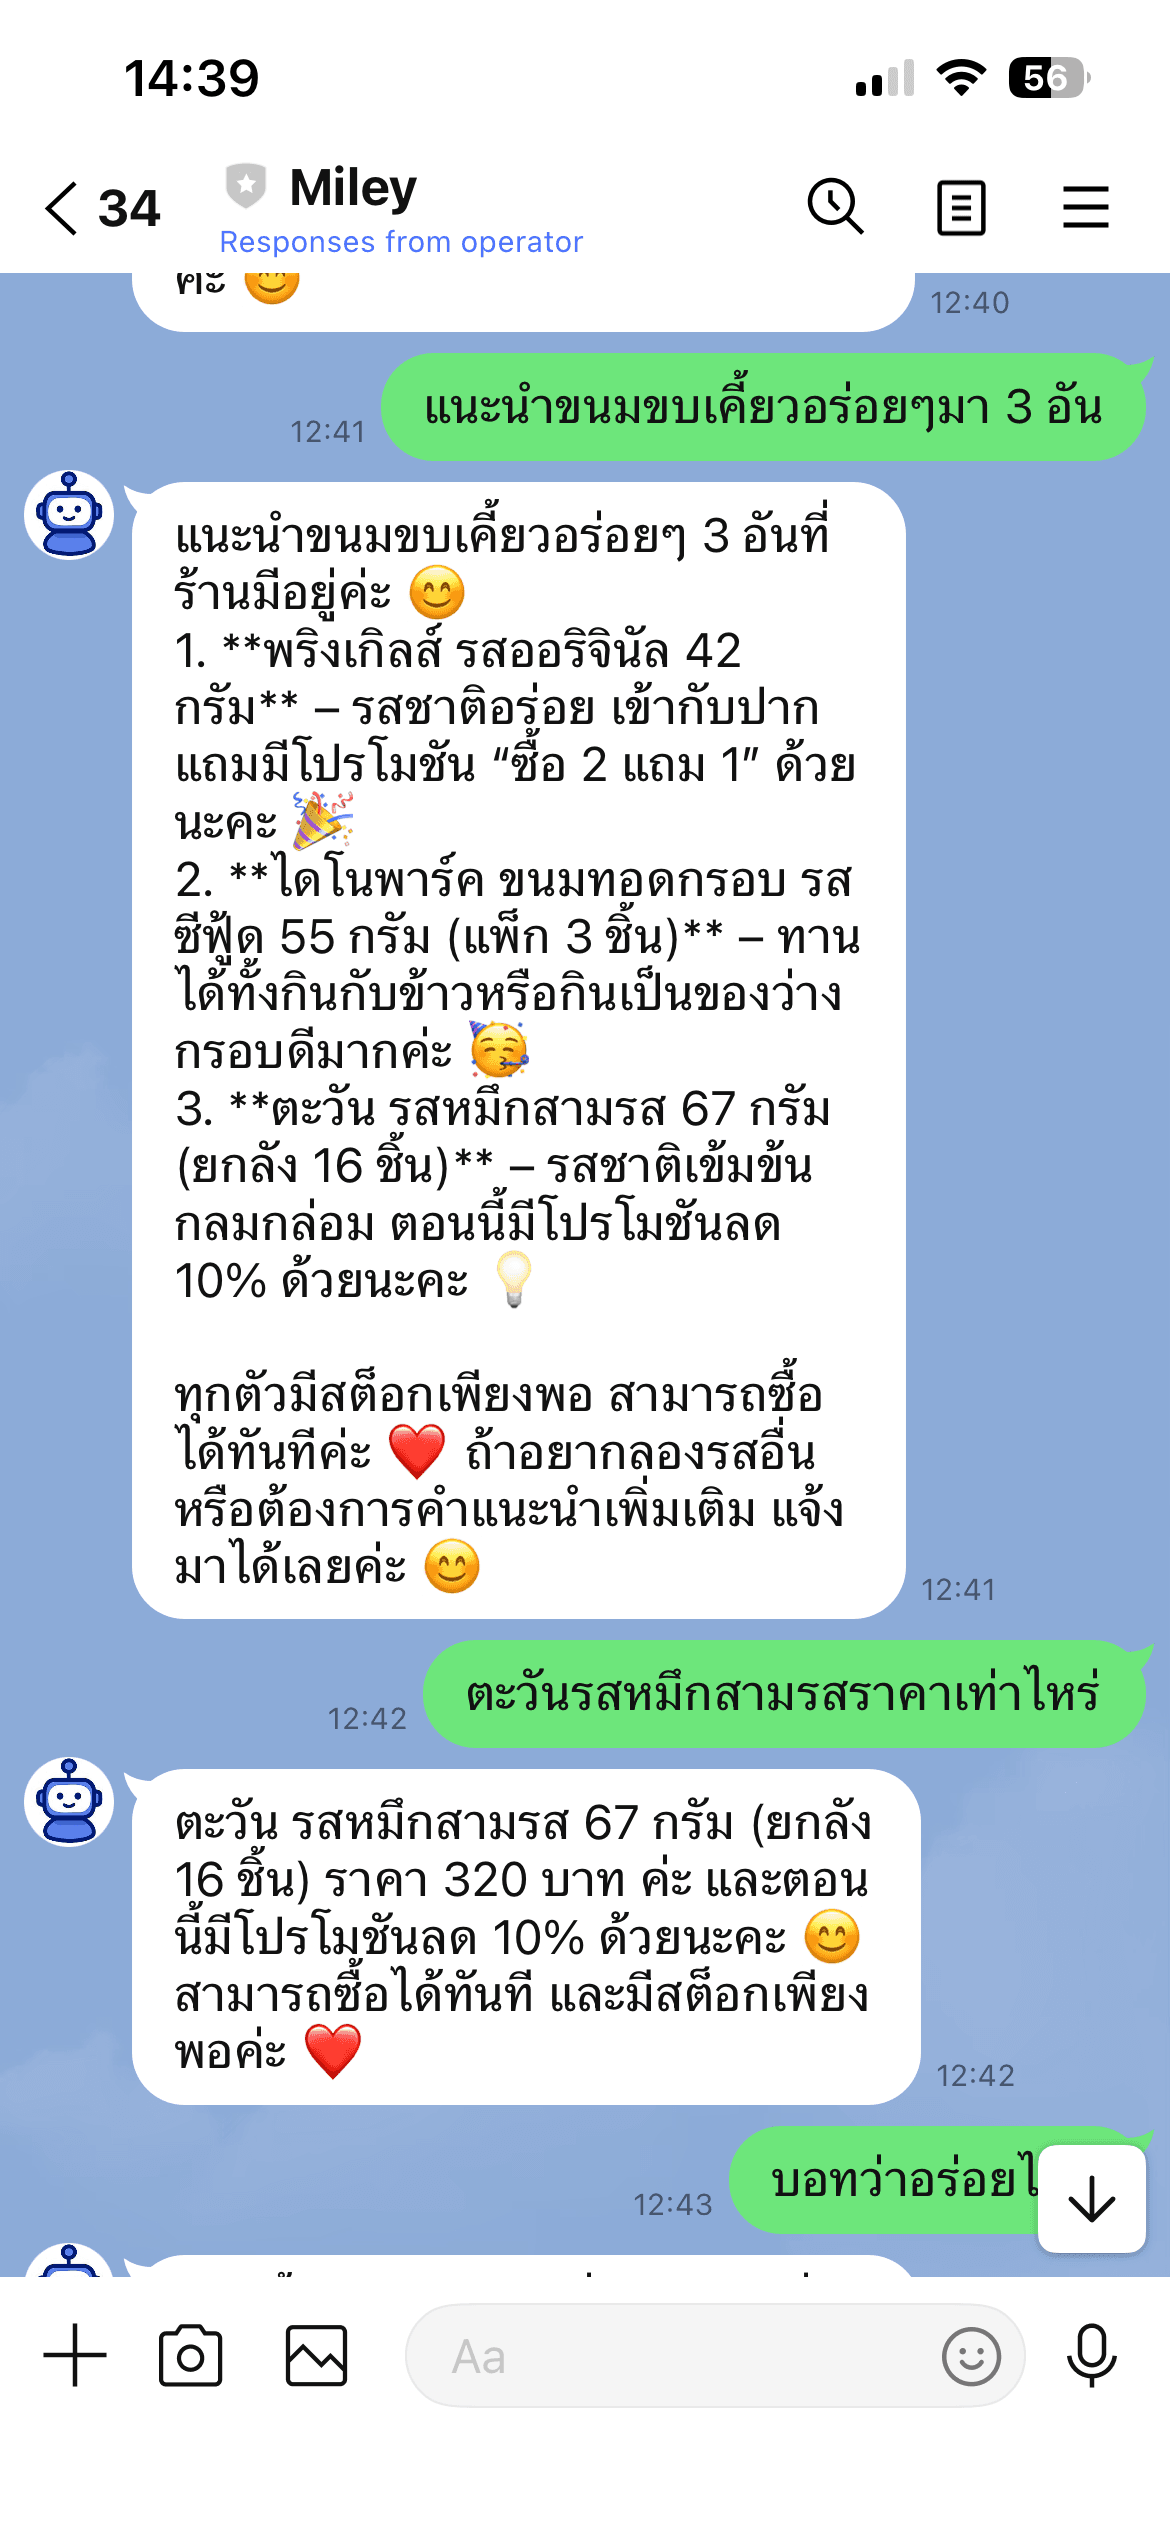
ตัวอย่างการตอบคำถามของแชตบอต (3)
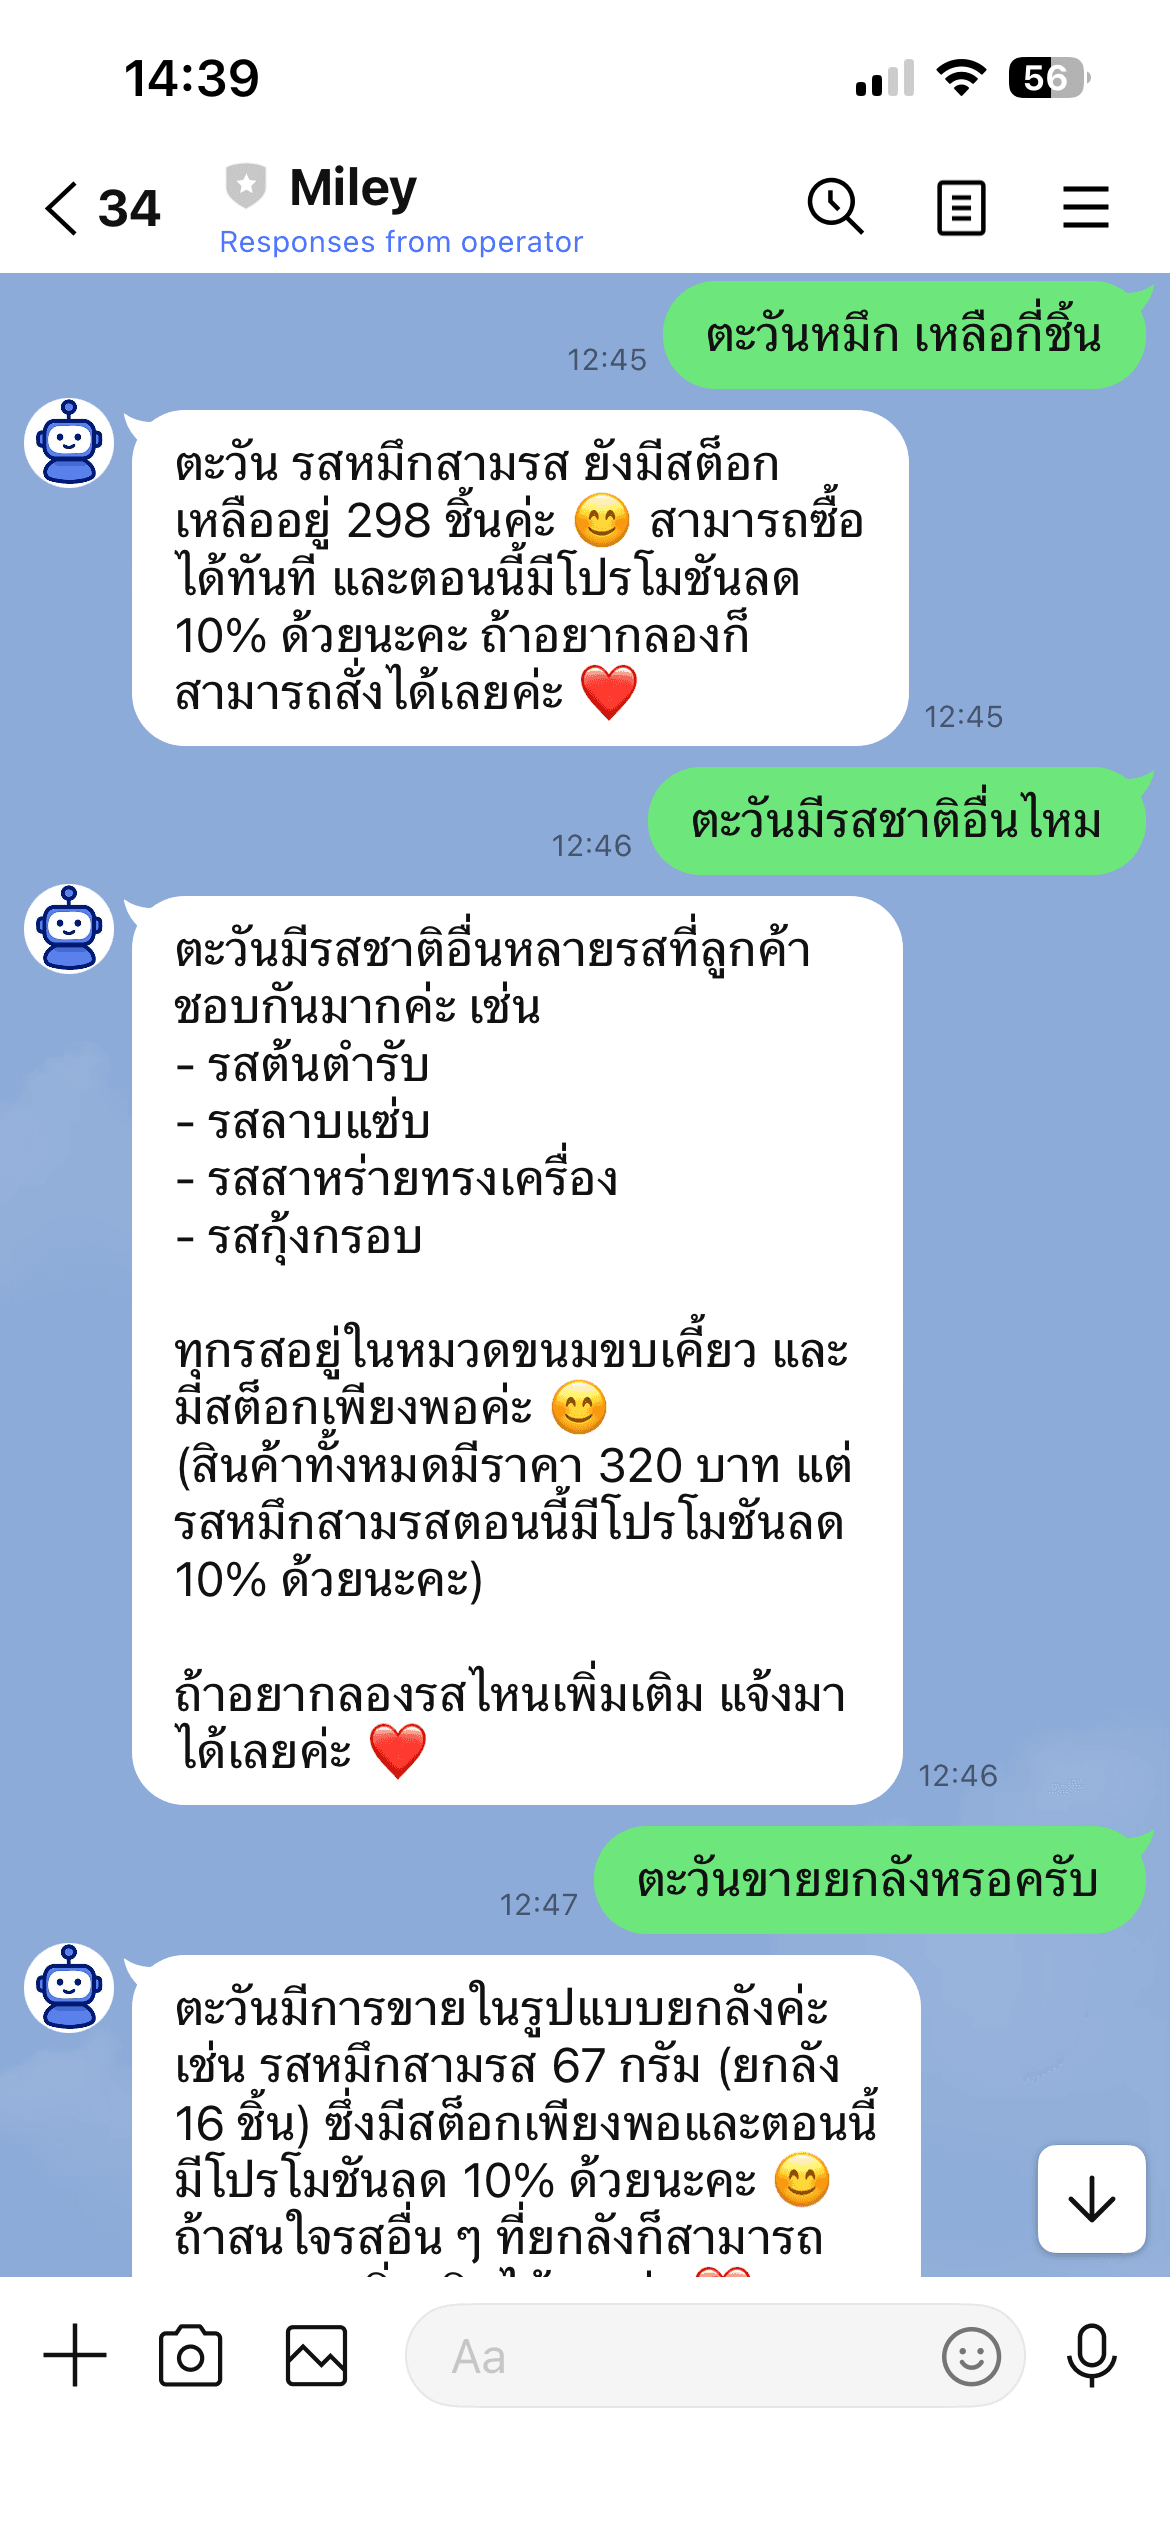
ตัวอย่างการตอบคำถามของแชตบอต (4)
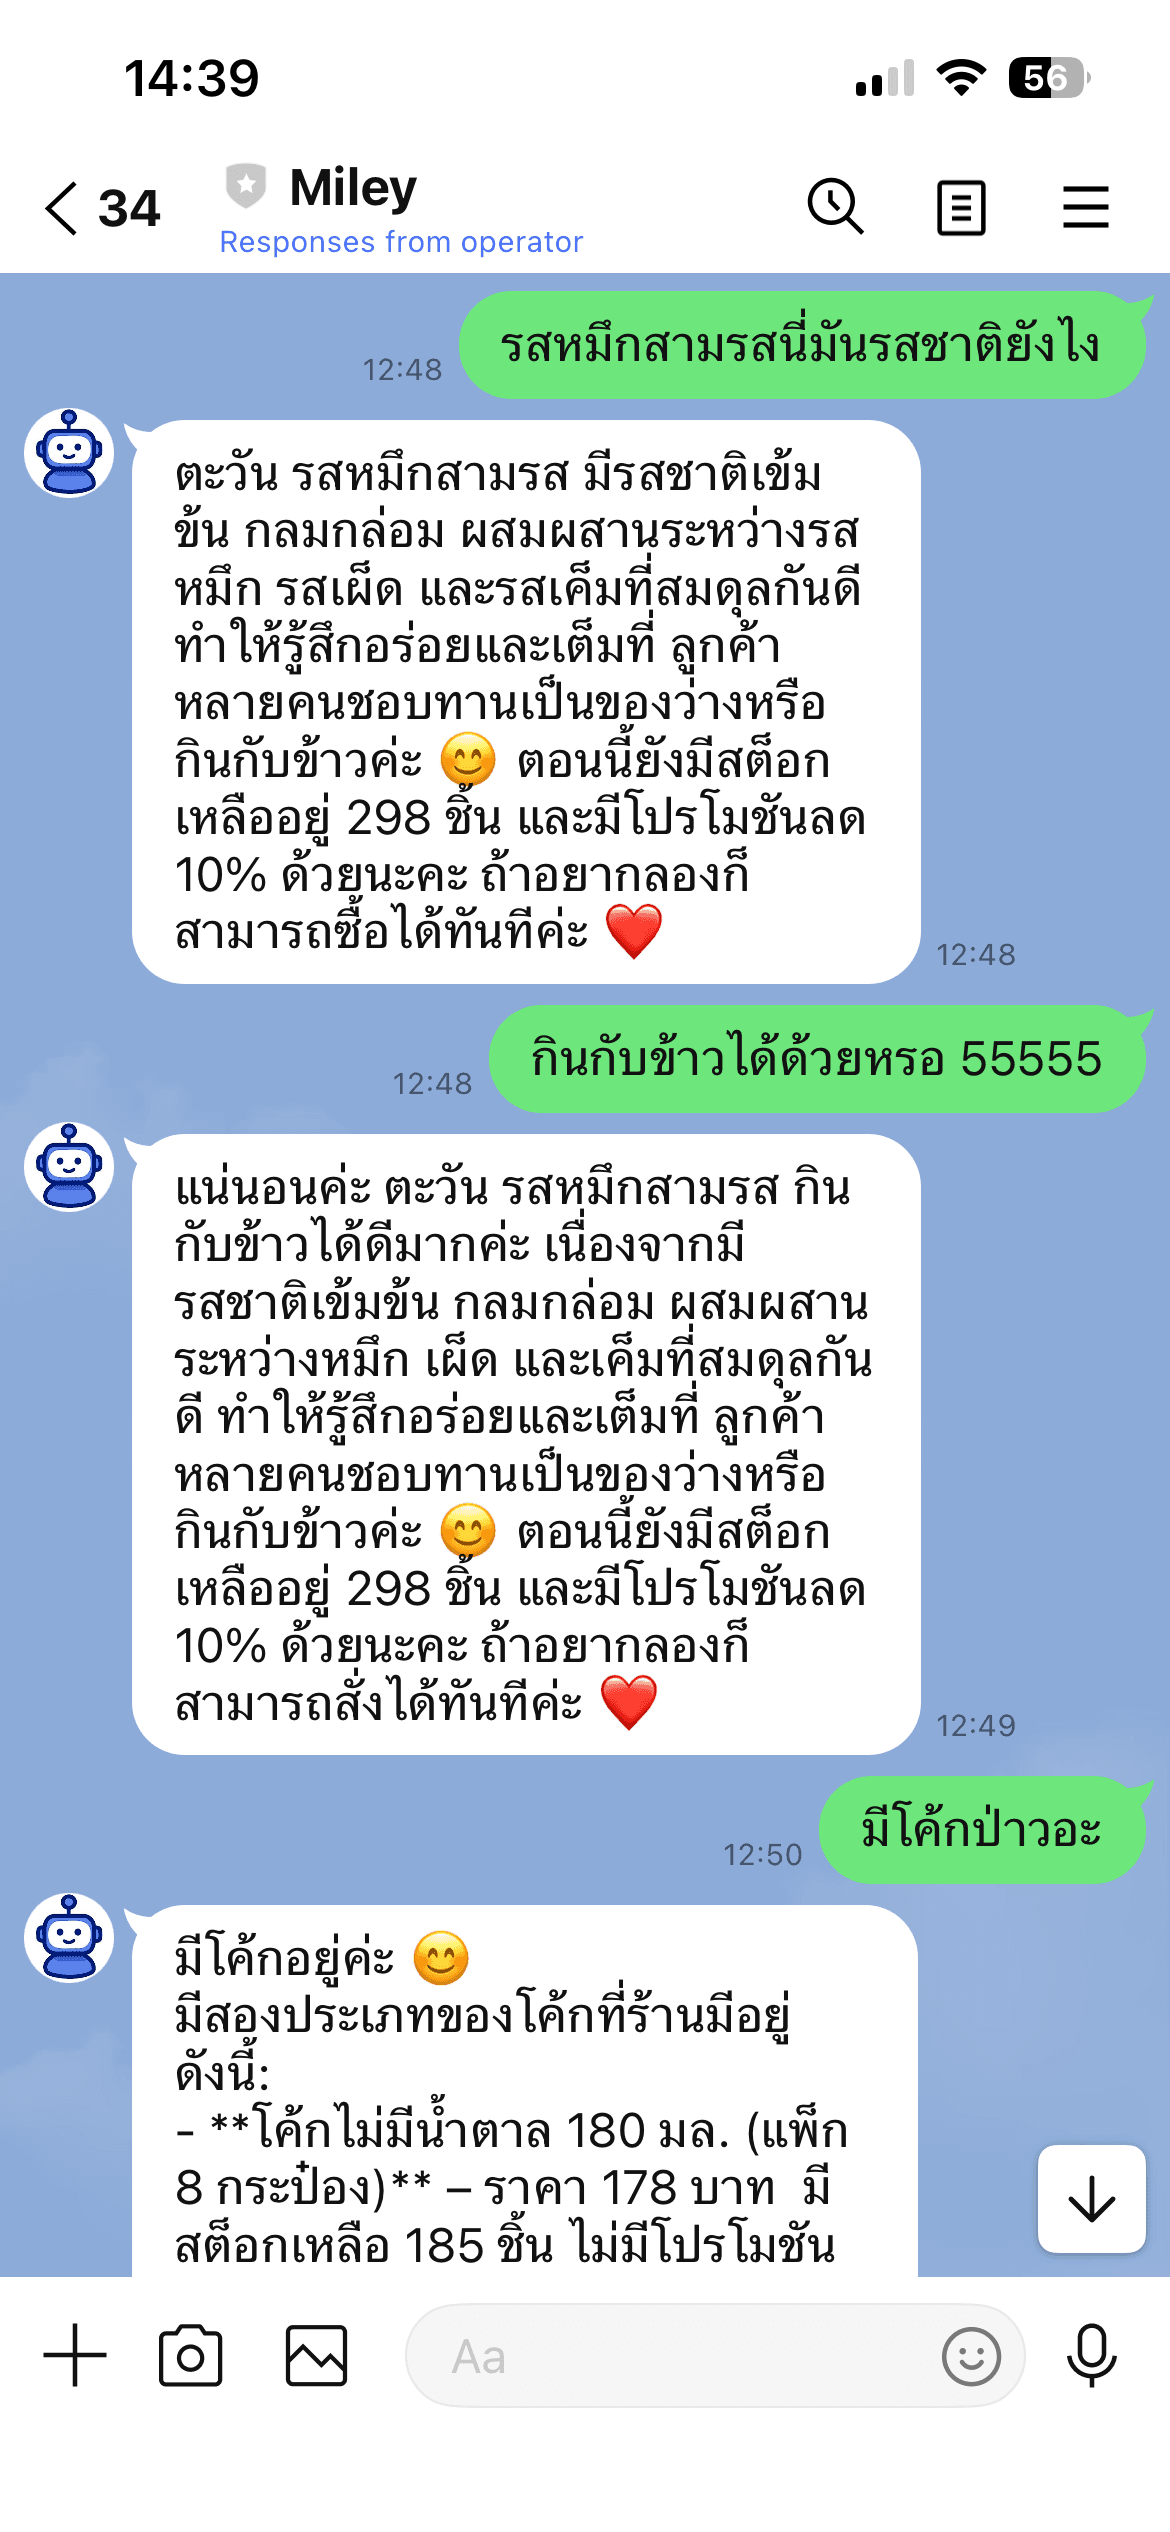
ตัวอย่างการตอบคำถามของแชตบอต (5)
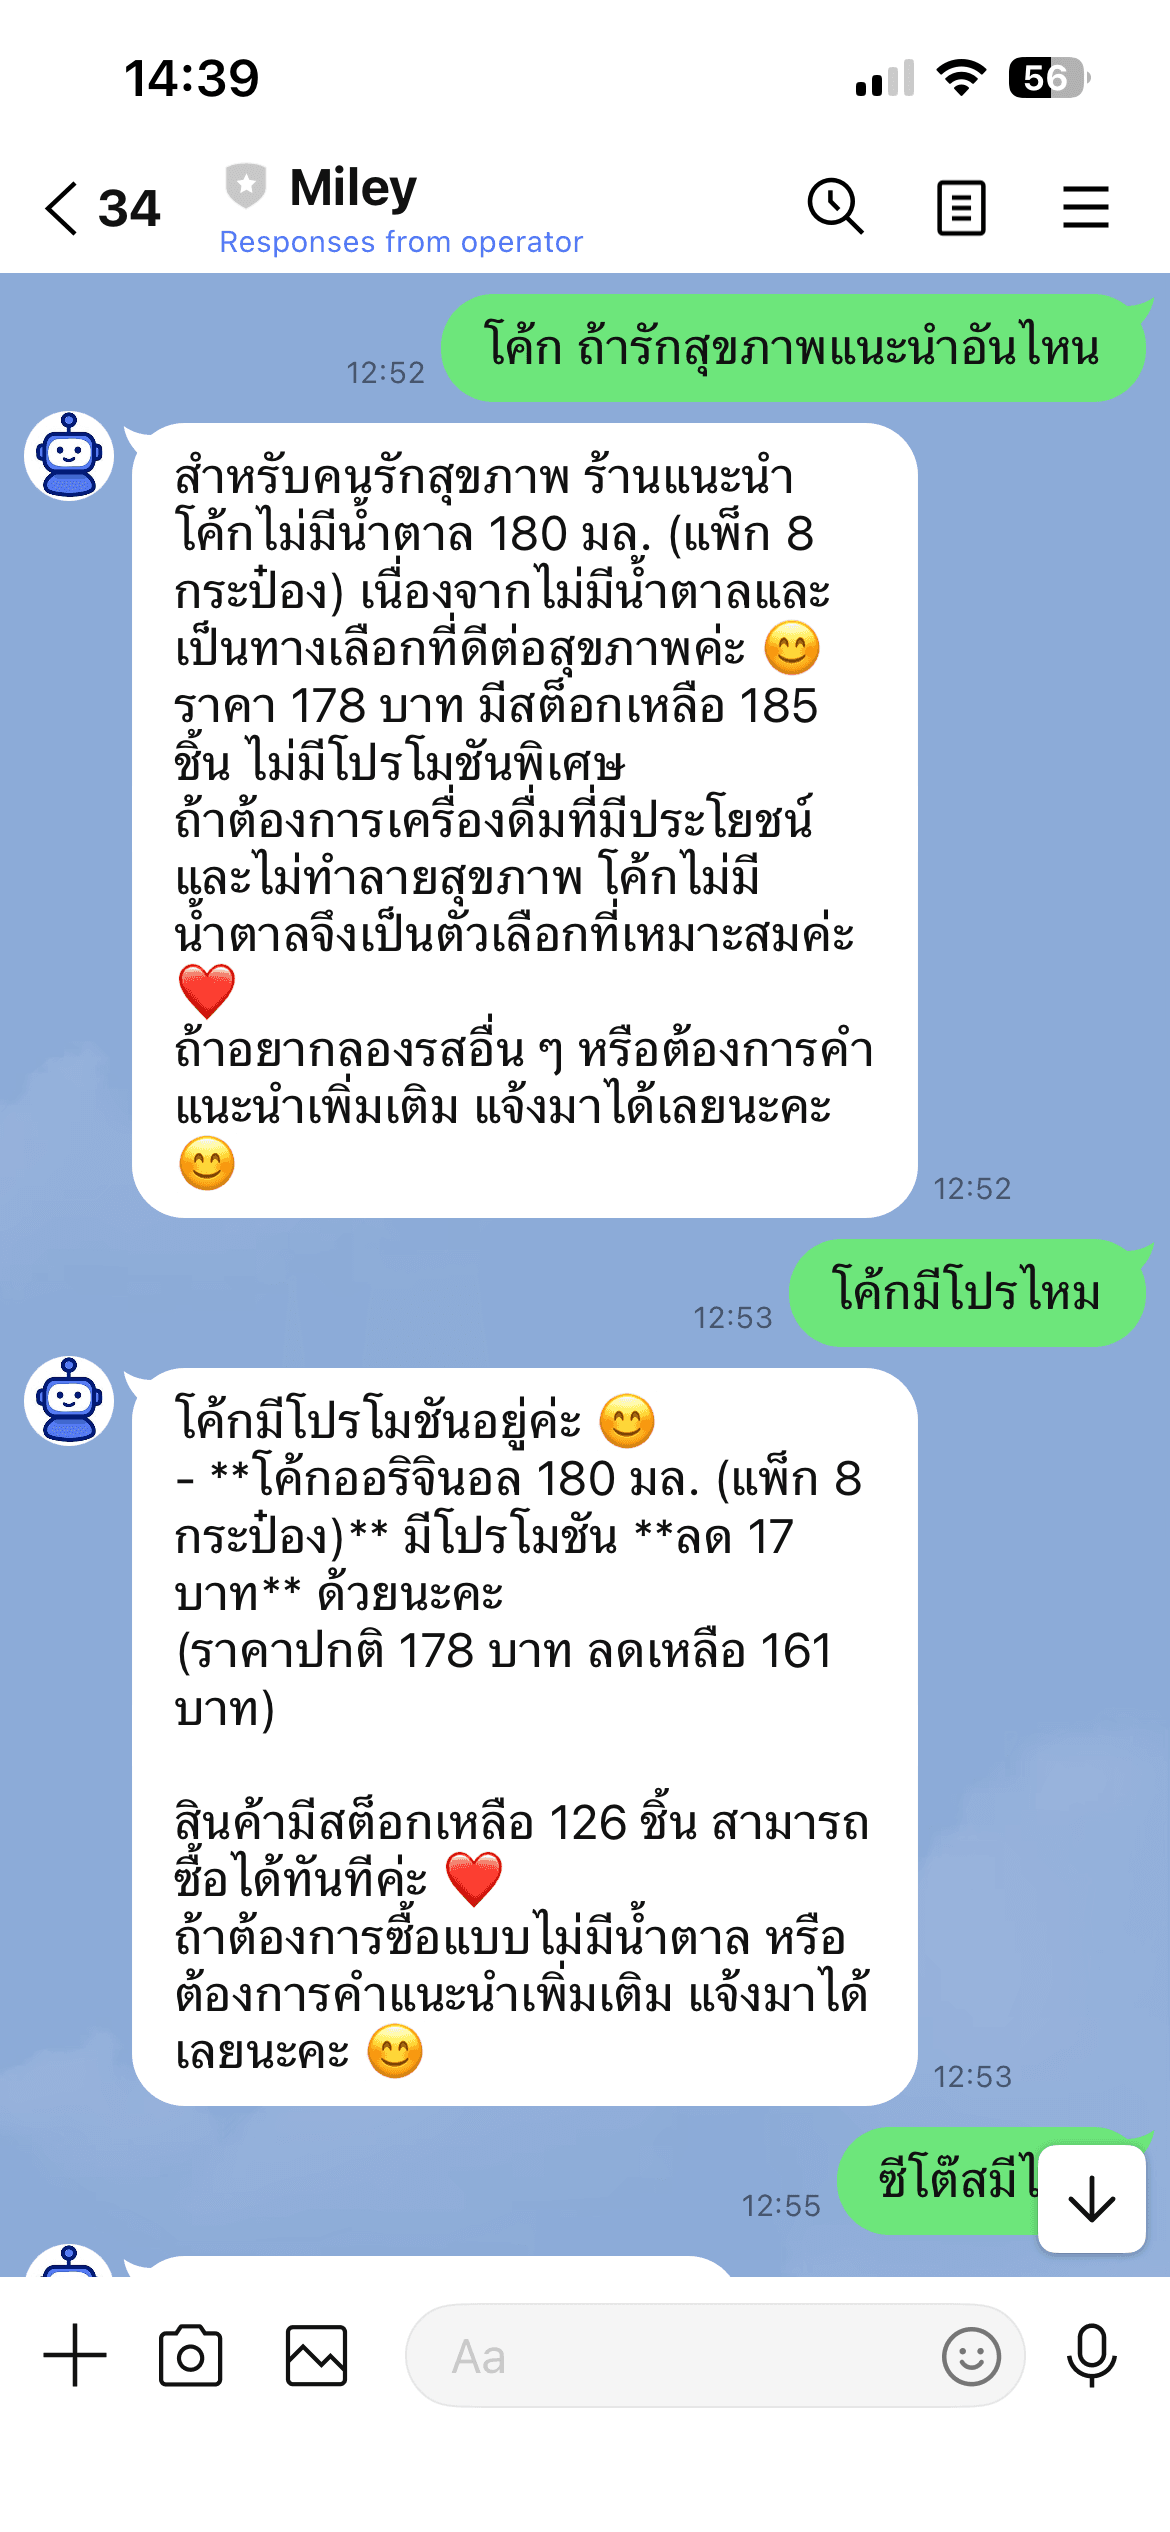
ตัวอย่างการตอบคำถามของแชตบอต (6)
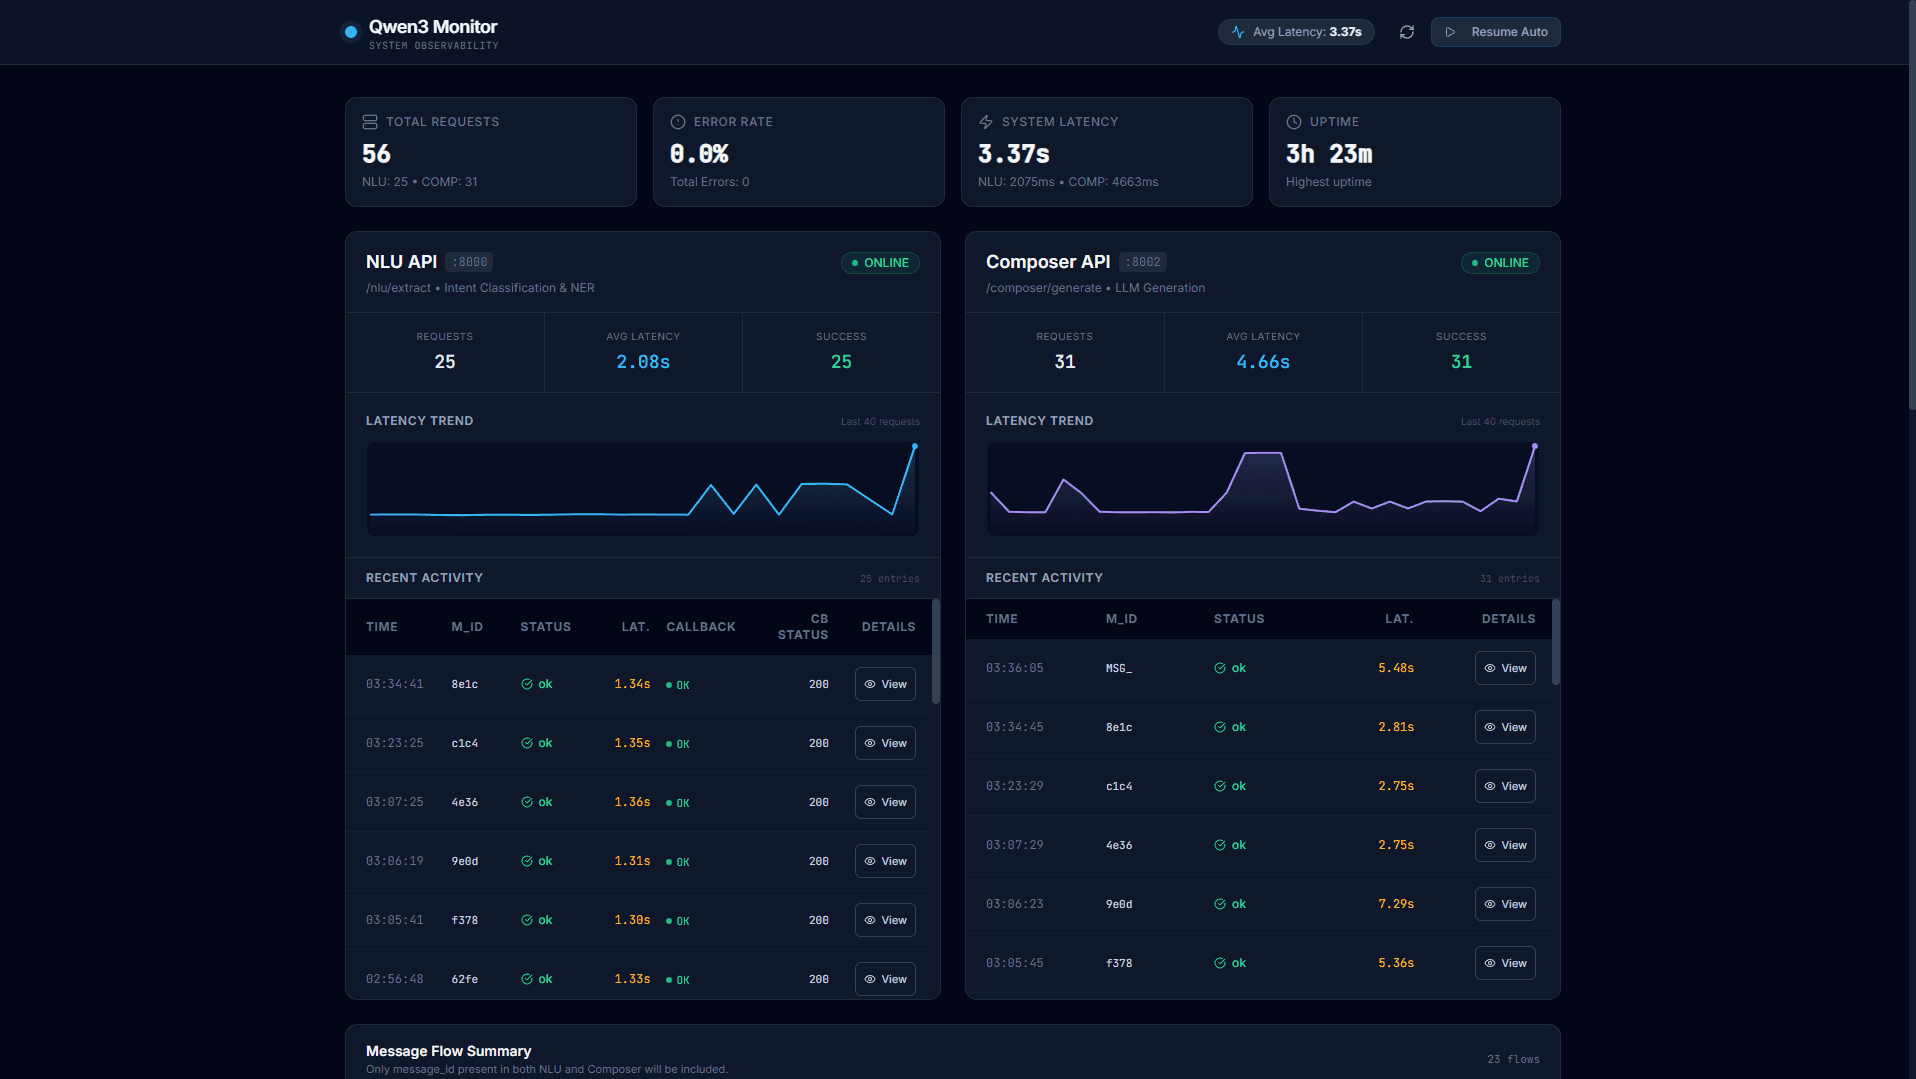
หน้าระบบ Monitoring การทำงานของ QWEN LLM ที่ผมพัฒนา
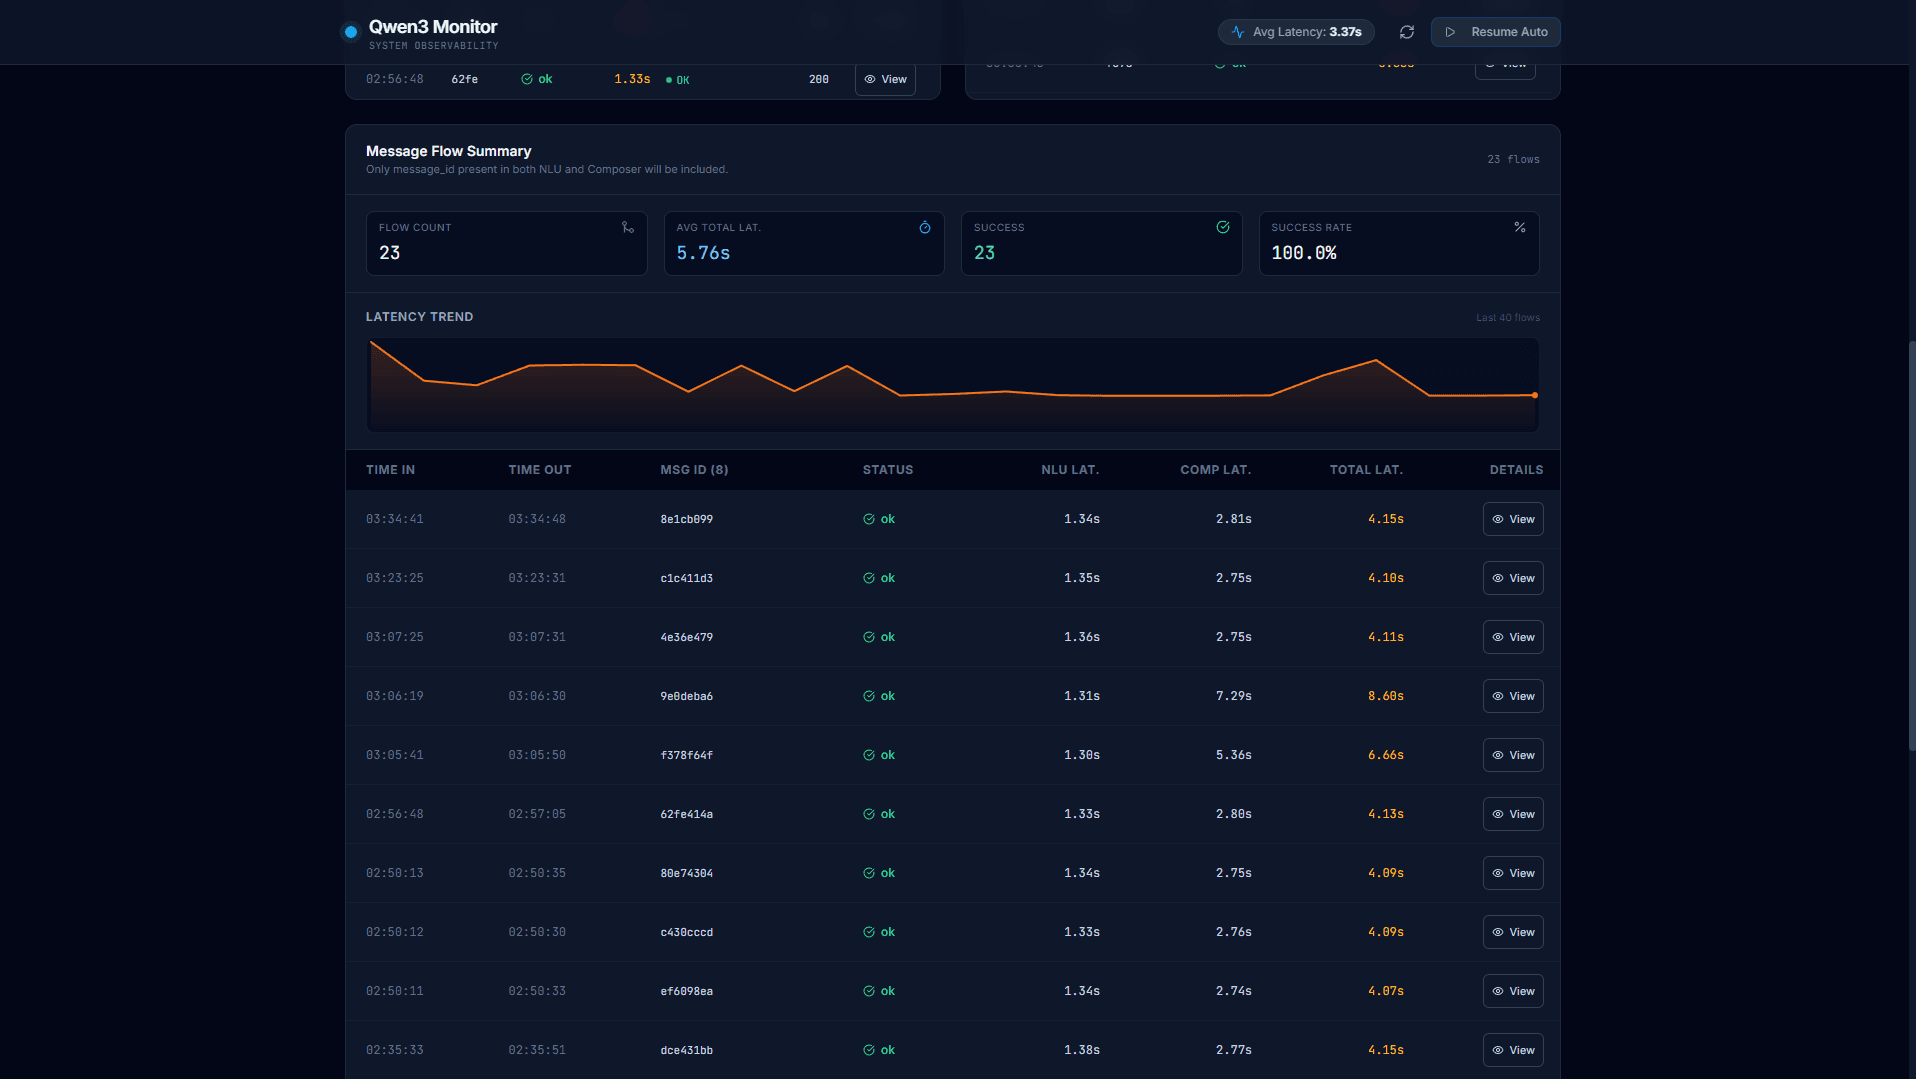
หน้าระบบ Monitoring การทำงานของ QWEN LLM ที่ผมพัฒนา (ต่อ)
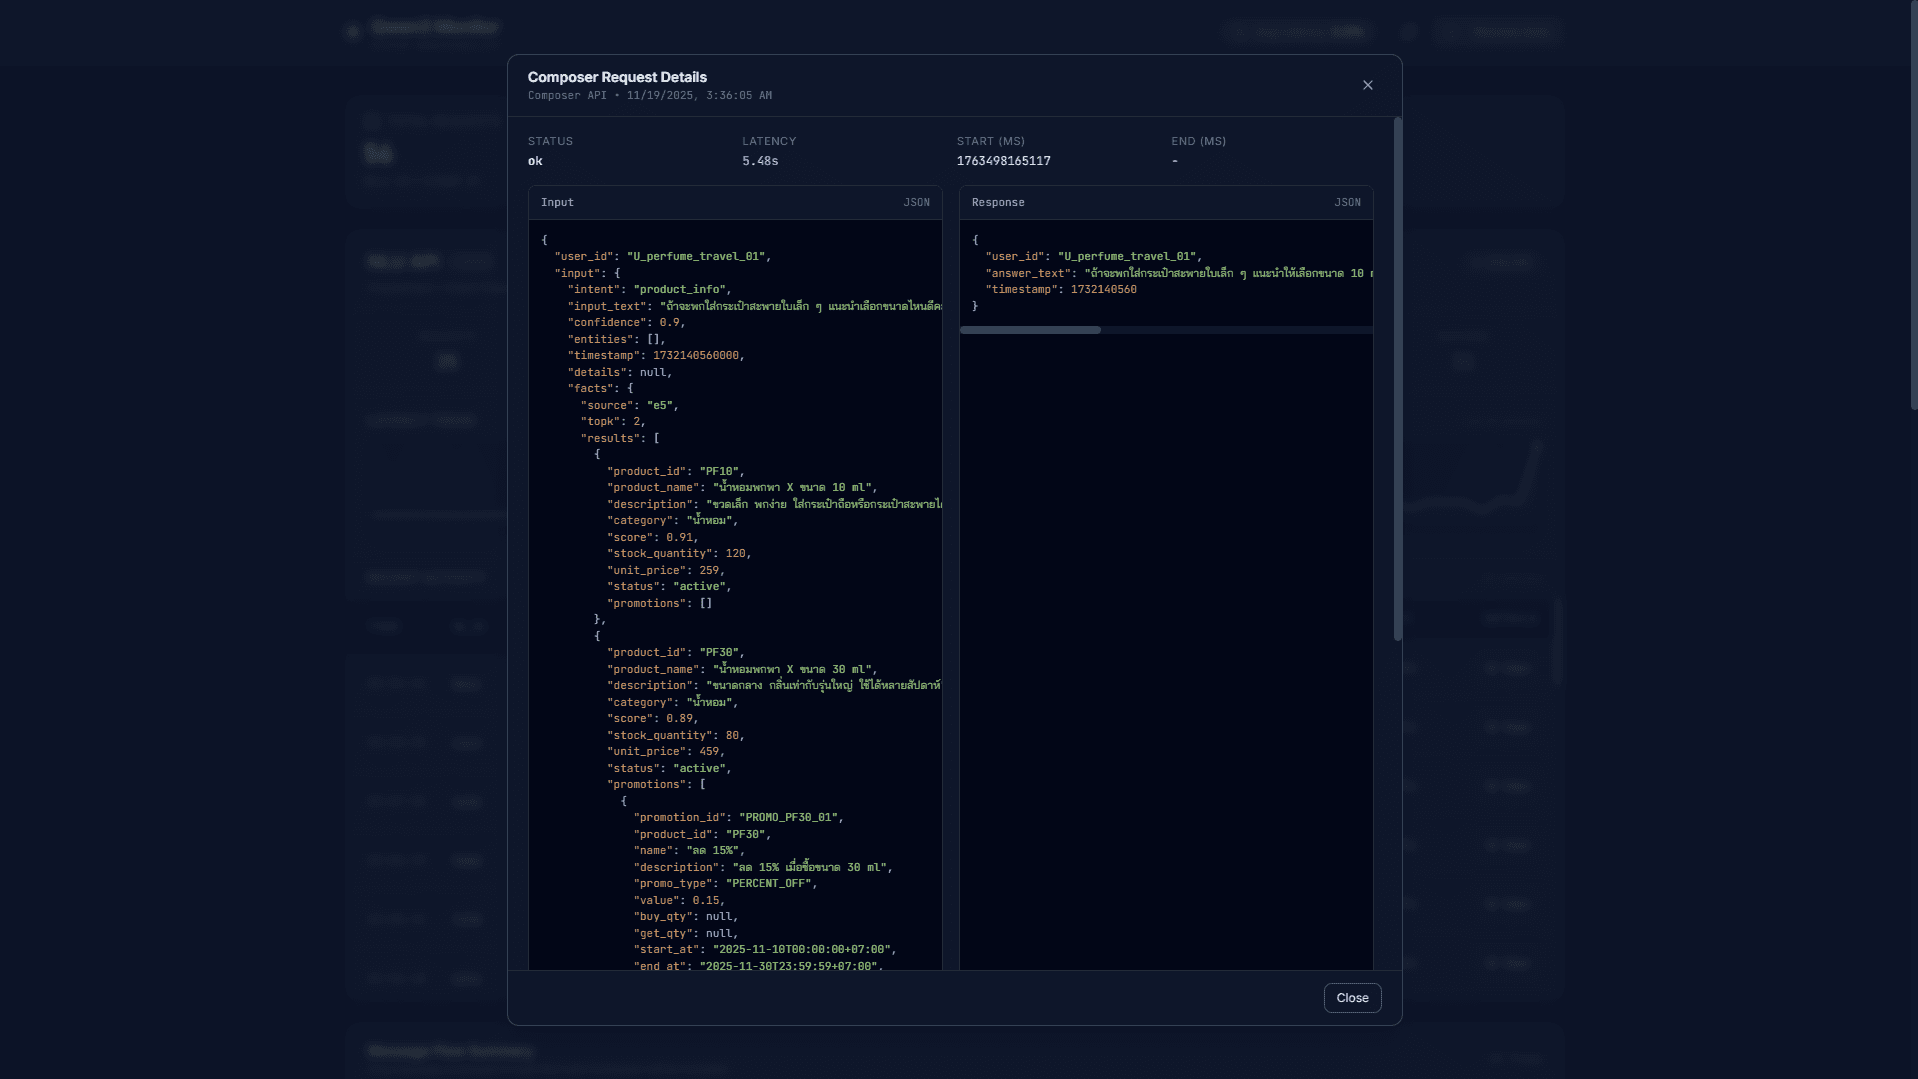
หน้าระบบ Monitoring การทำงานของ QWEN LLM ที่ผมพัฒนา ส่วนการตรวจสอบ input/response (ต่อ)
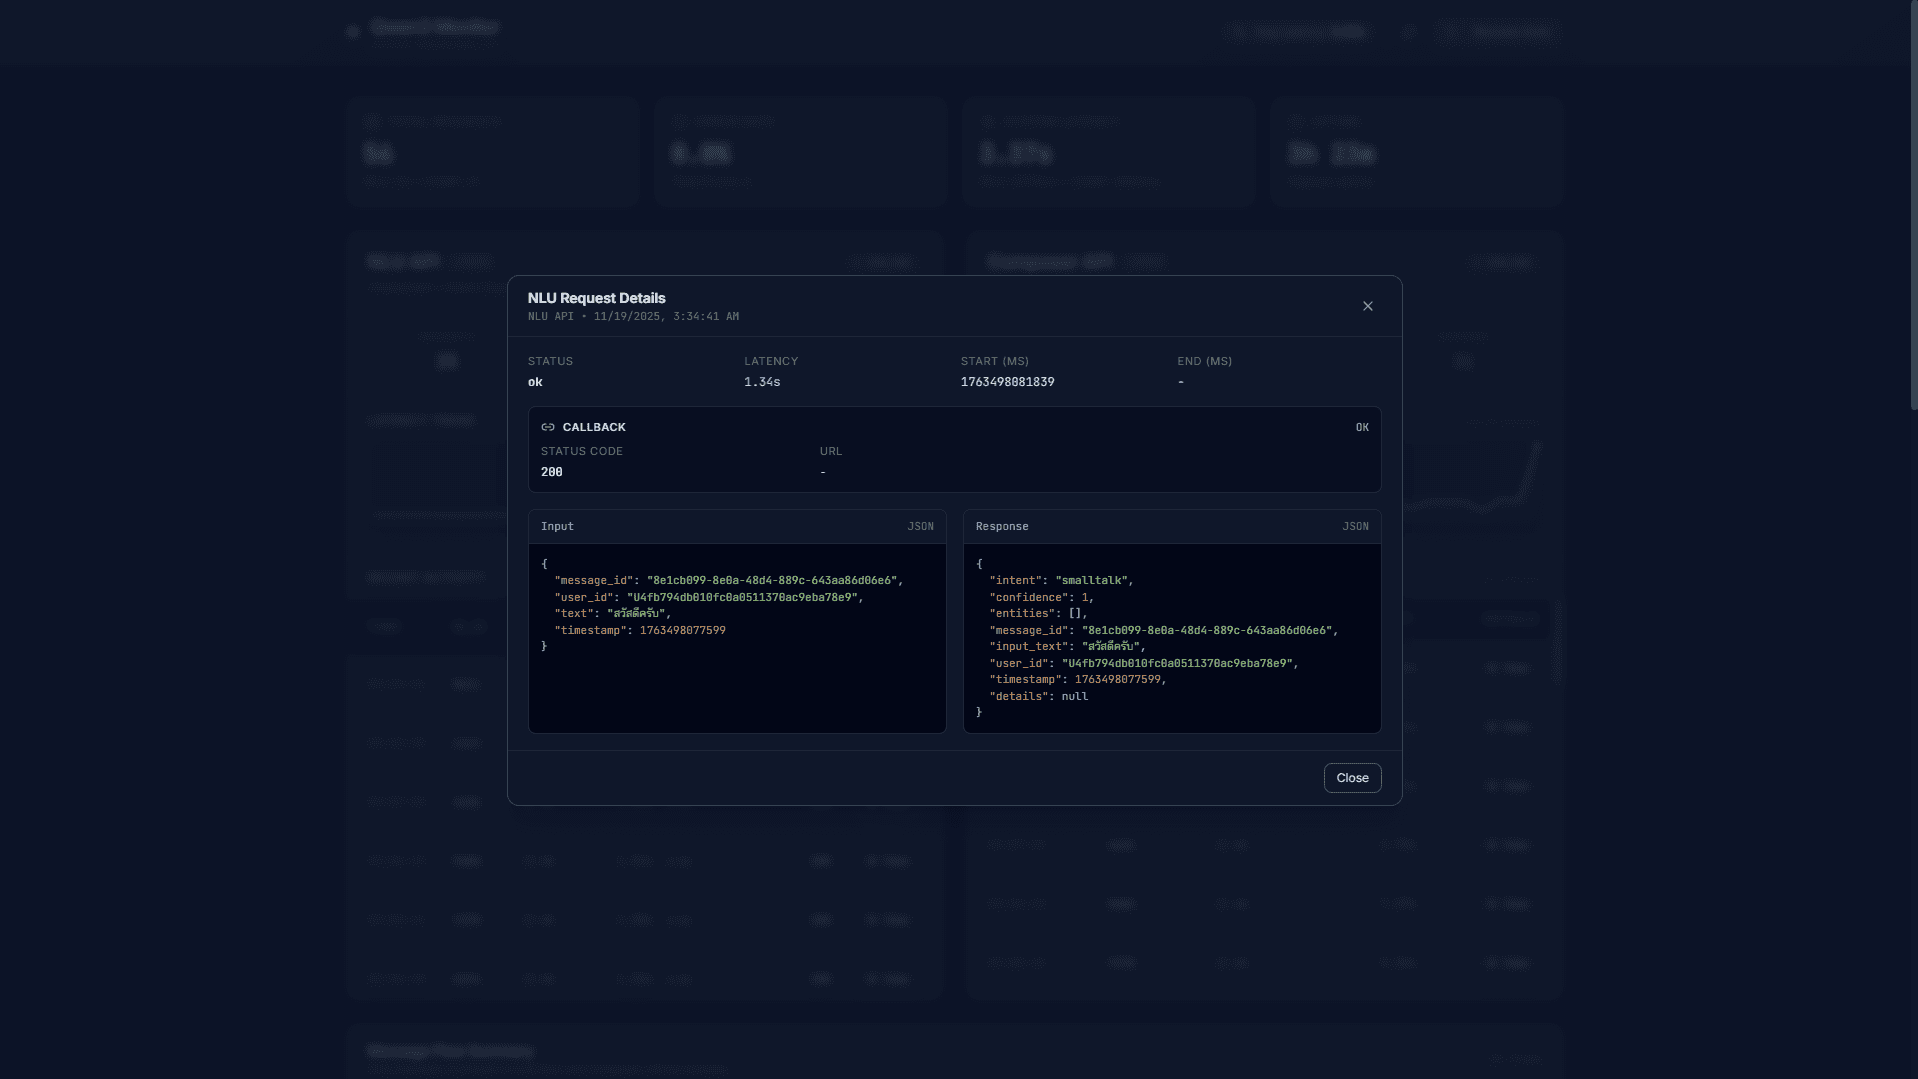
หน้าระบบ Monitoring การทำงานของ QWEN LLM ที่ผมพัฒนา ส่วนการตรวจสอบ input/response (ต่อ)
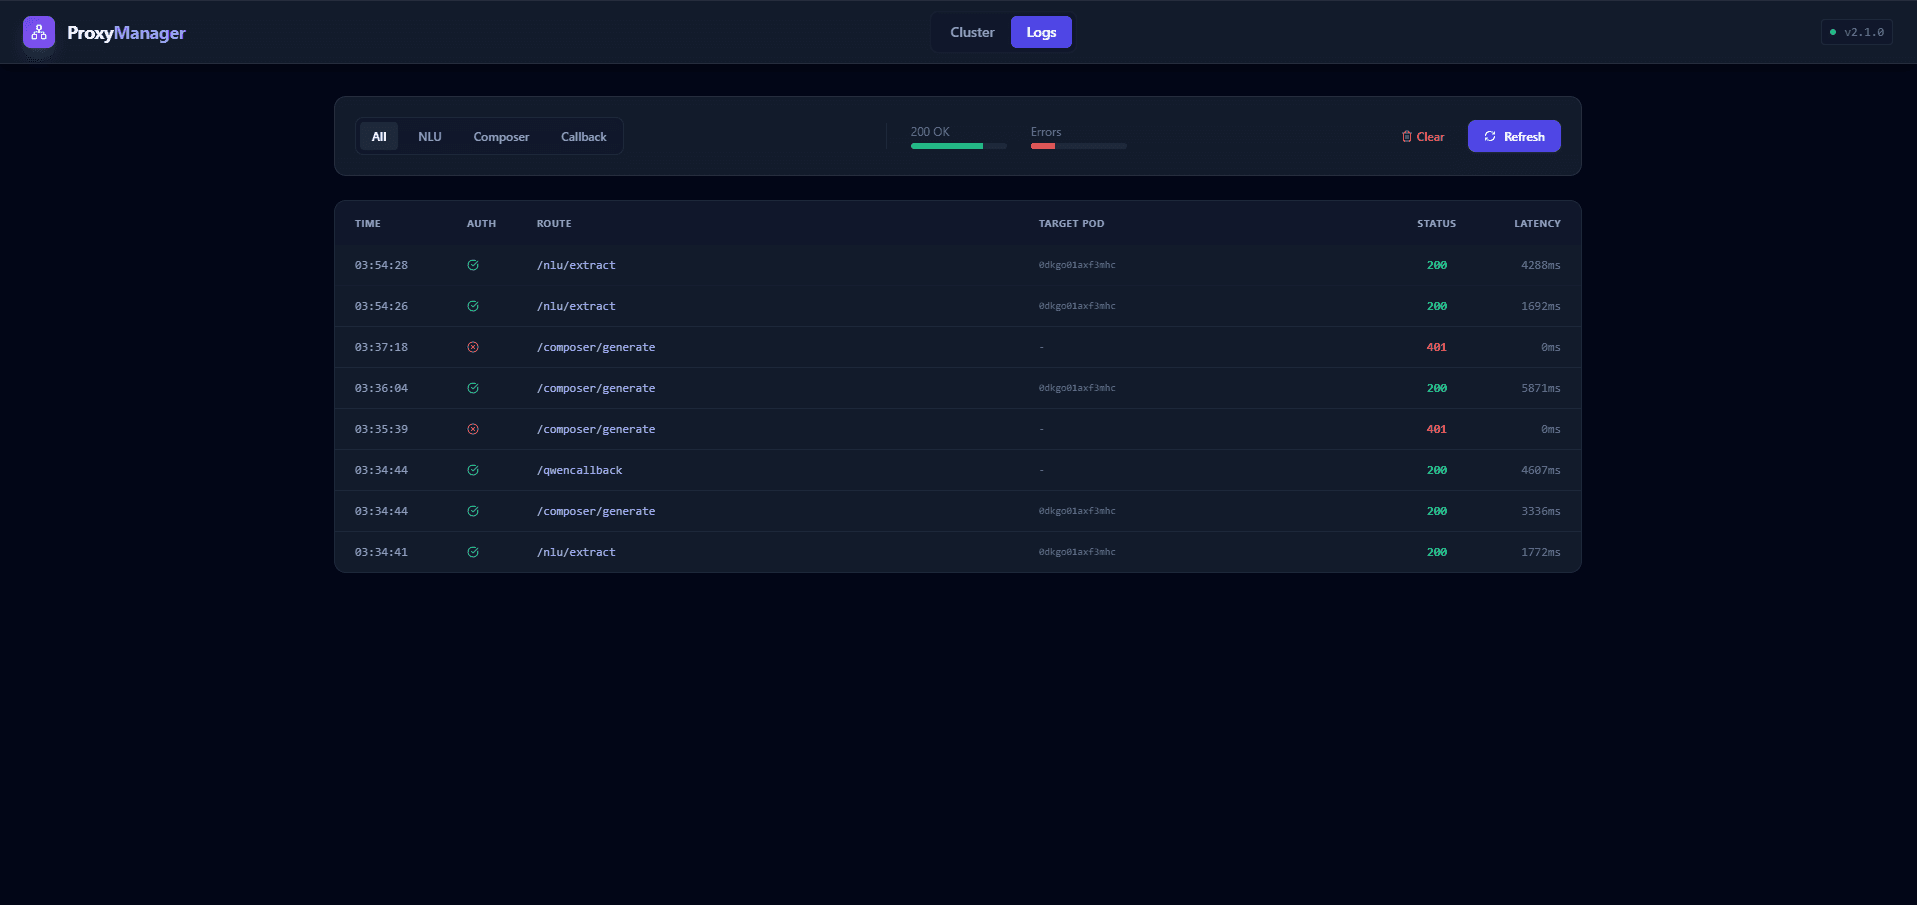
หน้าระบบ Monitoring Proxy Server ที่เชื่อมระหว่าง LLM กับ Vector Search และส่วน Orchestrator
Section 2
9:16 / MDทบทวนโปรเจกต์
ความท้าทาย
- การออกแบบ Data Pipeline ให้ข้อมูลไหลผ่านส่วน Extractor → Vector Search → Composer ได้อย่างถูกต้องและตรวจสอบได้
- การเรียนรู้การสั่งงานโมเดลภาษา (Prompt/Instruction) และการทดสอบผ่านข้อมูลจำนวนมากเพื่อปรับคุณภาพคำตอบให้สม่ำเสมอ
- การปรับจูนโมเดลและจัดการทรัพยากรการประมวลผลบน GPU Cloud ให้คุ้มค่าและเหมาะสมกับรอบการทดลอง
- การควบคุมความคลาดเคลื่อนของคำตอบ (เช่น Hallucination) และทำให้ผลลัพธ์อ้างอิงจากรายการสินค้าที่ค้นหาได้จริง
สิ่งที่เรียนรู้
- การออกแบบระบบ LLM แบบสองขั้น (Extractor/Composer) เพื่อเชื่อมงานทำความเข้าใจกับงานค้นหาและการสรุปคำตอบ
- การใช้งาน Hugging Face ในการทดลองและจัดการโมเดล รวมถึงการประเมินและปรับจูนให้เหมาะกับงานเฉพาะทาง
- การใช้งาน GPU Cloud (Runpod.io) สำหรับงานฝึก/ทดลองโมเดล และการบริหารรอบการทดลองอย่างมีประสิทธิภาพ
- หลักการทำ Data Pipeline และการไหลของข้อมูลในงาน Big Data ที่ต้องเชื่อมหลายโมดูลเข้าด้วยกันอย่างเป็นระบบ
- แนวทางลดความคลาดเคลื่อนของ LLM ด้วยการจำกัดบริบทให้ยึดจากผลลัพธ์ Vector Search และการออกแบบ Prompt ให้ชัดเจน
สนใจงานแนวนี้?
เล่าโจทย์ของคุณให้ผมฟัง ตอบกลับภายใน 24 ชั่วโมง