โปรเจกต์ส่วนตัว·2026·Web App · Local-first · Browser Extension
BookNest — ห้องสมุดส่วนตัวพร้อมแผนที่ความรู้ของหนังสือ
ห้องสมุดหนังสือและนิตยสารแบบ local-first ที่เก็บสารบัญจริง คำศัพท์ ผัง และเส้นทางอ่านของแต่ละเล่มไว้เป็น JSON ที่ตรวจสอบได้ ไม่ต้องมีบัญชีหรือคลาวด์
- บทบาท
- นักพัฒนาเดี่ยว — โมเดลข้อมูล Frontend ข้อกำหนด JSON และตัวตรวจ กราฟ ส่วนขยาย Chrome และสคริปต์ตรวจสอบ
- ทีม
- งานเดี่ยว
- ระยะเวลา
- 17–30 ก.ย. 2026
- ปี
- 2026
ตัวเลขสำคัญ
- 11
- โมเดลข้อมูล (SQLite)
- 7
- ชนิดผังความรู้
- 6
- ชนิดความสัมพันธ์
- 6
- ชนิดรายการในสารบัญ
- 3
- สคริปต์ตรวจสอบ
- 1.3.0
- เวอร์ชันส่วนขยาย Chrome
BookNest เป็นห้องสมุดส่วนตัวสำหรับหนังสือและนิตยสารที่รันบนเครื่องตัวเอง ใช้ SQLite และเก็บปกไว้ในโฟลเดอร์ในเครื่อง ไม่ต้องมีบัญชี คลาวด์ หรืออินเทอร์เน็ต นอกจากจดสถานะการอ่าน ความสำคัญ โน้ต และแท็กแล้ว แต่ละเล่มมี “คลังความรู้” เป็นเอกสาร JSON เวอร์ชัน booknest-knowledge/v1 ที่ให้ AI ช่วยค้นคว้าตามพรอมป์ของแอป แล้วนำเข้ามาตรวจ: สารบัญจริง (แยกจากแผนที่เนื้อหาที่ AI สังเคราะห์), คำศัพท์, ความเชื่อมโยง, ผัง, เส้นทางอ่าน และหนังสือที่เกี่ยวข้อง ข้อความทุกข้อมีป้ายว่าตรวจแล้วหรือสังเคราะห์ พร้อมที่มา และเผยแพร่เป็นหน้าอ่านอย่างเดียวเฉพาะเล่มที่เลือกได้ มีส่วนขยาย Chrome สำหรับนำเข้าหนังสือจาก Amazon Store
โจทย์และปัญหา
- 01หนังสือเทคนิคหลายเล่มอ่านค้างหรือซื้อมาแล้วไม่ได้เปิด ถ้ามีแค่ชื่อกับปกก็บอกไม่ได้ว่าเล่มนี้เกี่ยวกับอะไร เหมาะกับใคร และควรเริ่มอ่านตรงไหน
- 02AI สรุปเนื้อหาหนังสือได้แต่ปนข้อเท็จจริงกับการตีความ ถ้าแสดงแผนที่ที่ AI สังเคราะห์เป็นสารบัญจริงจะทำให้ผู้อ่านเข้าใจผิด
- 03ข้อมูลห้องสมุดเป็นของส่วนตัว ไม่ควรต้องฝากไว้กับบริการภายนอก และต้องสำรองและย้ายเครื่องได้ง่าย
- 04การพิมพ์ข้อมูลหนังสือทีละเล่มช้า และร้านออนไลน์หลายแห่งไม่มีวิธีส่งออกรายการ
วิธีแก้
- 01ห้องสมุดแบบ local-first: Next.js + Prisma + SQLite (11 โมเดล) ปกเก็บบนดิสก์ในเครื่อง ไม่มีบัญชีหรือคลาวด์ สร้างฐานข้อมูลครั้งแรกอัตโนมัติจาก migration ที่ commit ไว้ และสำรองเป็น ZIP ที่รวมฐานข้อมูลกับปกได้จากหน้า Settings
- 02จัดการหนังสือและนิตยสารในที่เดียว: ผู้แต่งหลายคน ISBN-10/13 ที่ตรวจเลขตรวจสอบ ฉบับ ปี สำนักพิมพ์ แท็ก สถานะ (Want to read, Reading, Finished, On hold, Archived) ความสำคัญ รายการโปรด ตรวจหนังสือซ้ำก่อนบันทึก และนำเข้าข้อมูลจากลิงก์หน้าหนังสือ (ใช้ Cheerio) หรือวางภาพปกด้วย Ctrl/⌘+V ส่วนนิตยสารบันทึกบทความรายชิ้นพร้อมสถานะอ่านแล้ว
- 03ข้อกำหนดโครงสร้างข้อมูล (data contract) booknest-knowledge/v1 ตรวจด้วย Zod ครบทุกชั้น: แหล่งที่มา, ภาพรวม, โปรไฟล์เทคนิค, สารบัญ (6 ชนิดรายการ), แผนที่เนื้อหา, คำศัพท์, ความสัมพันธ์ (6 ชนิด), ผัง (7 ชนิด), เส้นทางอ่าน และ errata กติกาสำคัญ: รายการสารบัญจริงต้องมีแหล่งที่มา ข้อความที่ติดป้าย “ตรวจแล้ว” ต้องมีแหล่งอ้างอิง และ JSON ต้องตรงกับข้อมูลระบุตัวเล่มที่กำลังแก้ (ชื่อ ผู้แต่ง ฉบับ ปี ISBN)
- 04ขั้นตอนทำงานร่วมกับ AI: ปุ่มคัดลอกพรอมป์ที่เติมชื่อ ผู้แต่ง ฉบับ ปี และ ISBN ของเล่มนั้นให้แล้ว พร้อมเทมเพลต JSON ที่มีตัวอย่างทุกคอลเลกชัน ผู้ใช้นำไฟล์ที่ AI คืนมานำเข้า ตัวแก้ไขตรวจทันทีและบอกตำแหน่งที่ผิด มีเลขรุ่นของข้อมูล (revision) กันการบันทึกทับเมื่อแก้จากอีกแท็บ
- 05หน้าอ่านคลังความรู้แบบแท็บ (ภาพรวม สารบัญจริง แผนที่เนื้อหา คำศัพท์ ความเชื่อมโยง ผัง เส้นทางอ่าน ที่มา) ค้นหาข้ามทั้งเล่มด้วย ⌘K และแสดงหนังสือที่เกี่ยวข้องจากหัวข้อที่ใช้ร่วมกัน
- 06กราฟความเชื่อมโยงและผังวาดด้วย React Flow โดยคำนวณเลย์เอาต์ด้วย ELK ใน Web Worker เพื่อไม่ให้หน้าค้าง รองรับผังที่มี cycle เส้นซ้ำ และ self-loop ส่งออกเป็น SVG หรือ PNG และเปิดเต็มจอได้
- 07เผยแพร่เฉพาะที่เลือก: เปิด “เผยแพร่ข้อมูลเล่มนี้” เพื่อได้หน้า /share/books/[id] แบบอ่านอย่างเดียว หรือรัน npm run publish เพื่อส่งออกเว็บ HTML อิสระของเล่มที่เผยแพร่ (ไม่มีโน้ตส่วนตัว สถานะการอ่าน ความสำคัญ รายการโปรด หรือปุ่มแก้ไข) และ npm run make สร้างรายการหนังสือแบบ offline ที่มีปุ่ม Load more
- 08ส่วนขยาย Chrome “Amazon Store Importer” (Manifest V3): อ่านการ์ดสินค้าที่เรนเดอร์ในแท็บ กดปุ่ม Load more ให้เอง ตรวจกับ metadata ของ Amazon แล้วส่งเฉพาะ URL ร้าน ASIN ชื่อ ผู้แต่ง ปีพิมพ์ และปกไปยัง BookNest ในเครื่อง หน้า /books/store-import ทำเครื่องหมายเล่มที่มีแล้ว ส่วนขยายไม่อ่านรหัสผ่าน ข้อมูลชำระเงิน หรือประวัติการเข้าเว็บ
ผลลัพธ์
- 01ห้องสมุดที่เปิดเล่มแล้วตอบได้ว่าเกี่ยวกับอะไร เหมาะกับใคร ต้องรู้อะไรก่อน และควรอ่านบทไหนก่อน โดยแยกสิ่งที่หนังสือระบุออกจากสิ่งที่ AI สังเคราะห์อย่างเห็นได้ชัด
- 02ข้อมูลทั้งหมดอยู่ในเครื่อง ไฟล์เดียว (SQLite) กับโฟลเดอร์ปก สำรองและย้ายเครื่องได้ด้วย ZIP
- 03มีสคริปต์ตรวจสอบ 3 ชุด: verify:knowledge (ตัวตรวจ JSON, หนังสือที่มีและไม่มี Part, revision, การบันทึก การลบ และการส่งออกสาธารณะกับฐานข้อมูลชั่วคราว), verify:graphs (เลย์เอาต์ของผัง) และ verify:graphs:browser (ตรวจผังในเบราว์เซอร์จริงด้วย Playwright)
สิ่งที่ส่งมอบ
- เว็บแอป Next.js 15 + Prisma + SQLite (11 โมเดล) พร้อม migration, backup ZIP และหน้า Settings
- ห้องสมุดหนังสือ/นิตยสาร กรอง ค้นหา ตรวจซ้ำ นำเข้าจากลิงก์ และจัดการผู้แต่ง สำนักพิมพ์ แท็ก
- ตัวตรวจ booknest-knowledge/v1, พรอมป์ AI, เทมเพลต JSON และตัวแก้ไข/อ่านคลังความรู้
- กราฟความเชื่อมโยงและผังด้วย React Flow + ELK (Web Worker) พร้อมส่งออก SVG/PNG
- หน้าแชร์อ่านอย่างเดียว การส่งออกเว็บ HTML (npm run publish) และรายการหนังสือ offline (npm run make)
- ส่วนขยาย Chrome Amazon Store Importer (Manifest V3, เวอร์ชัน 1.3.0)
- สคริปต์ตรวจสอบ verify:knowledge, verify:graphs และ verify:graphs:browser
แกลเลอรี
หนังสือและนิตยสาร (ข้อมูลตัวอย่าง)
16:9 / LG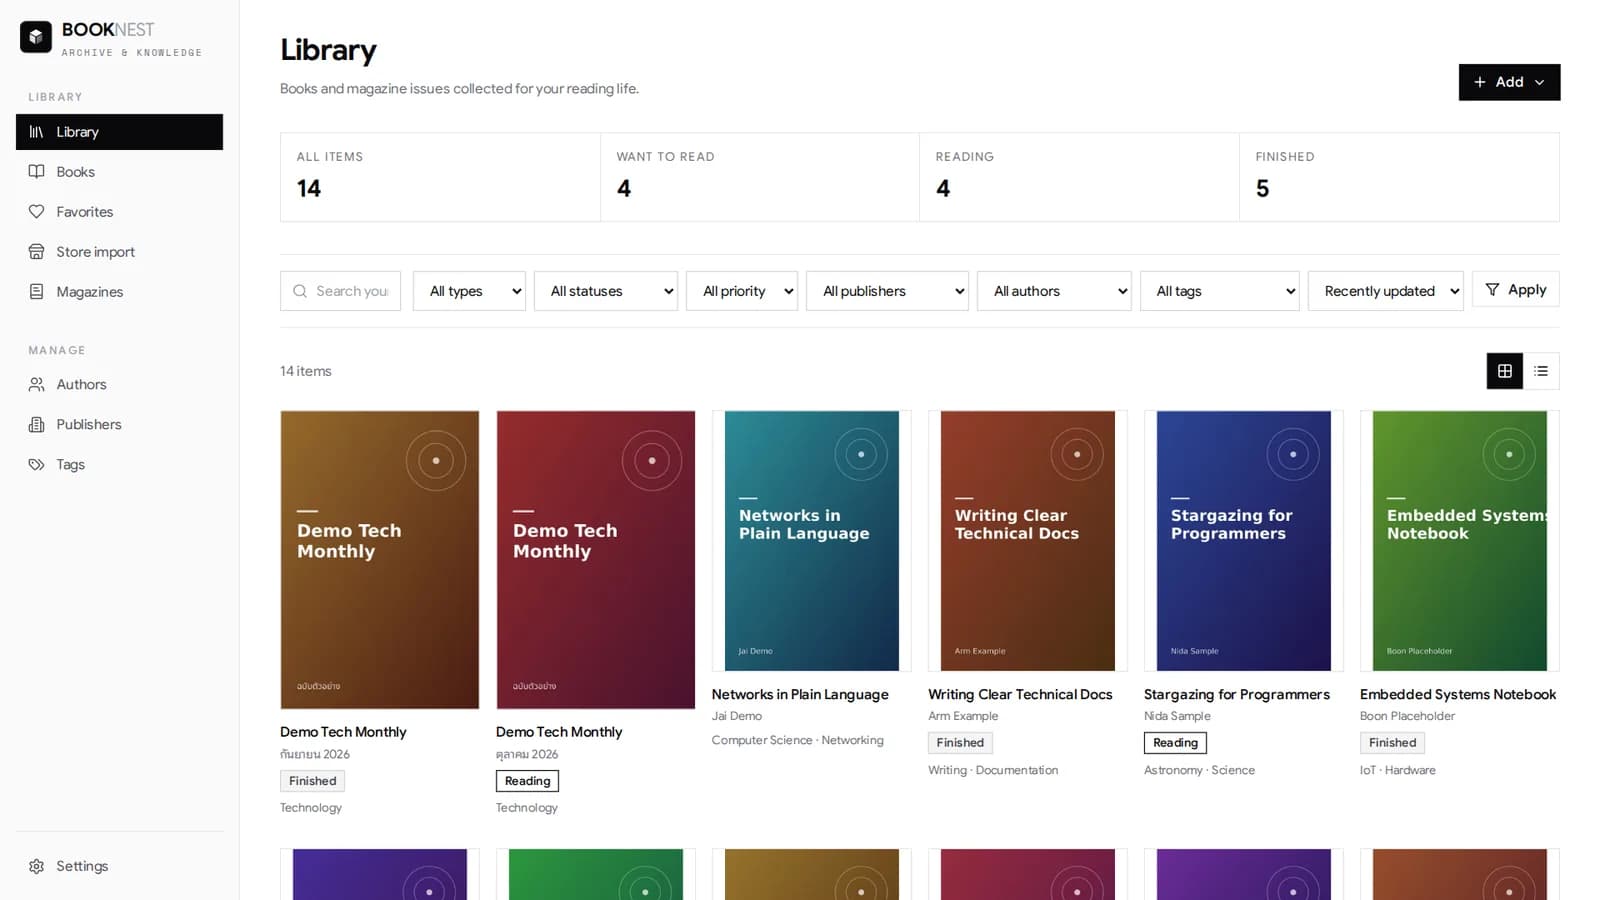
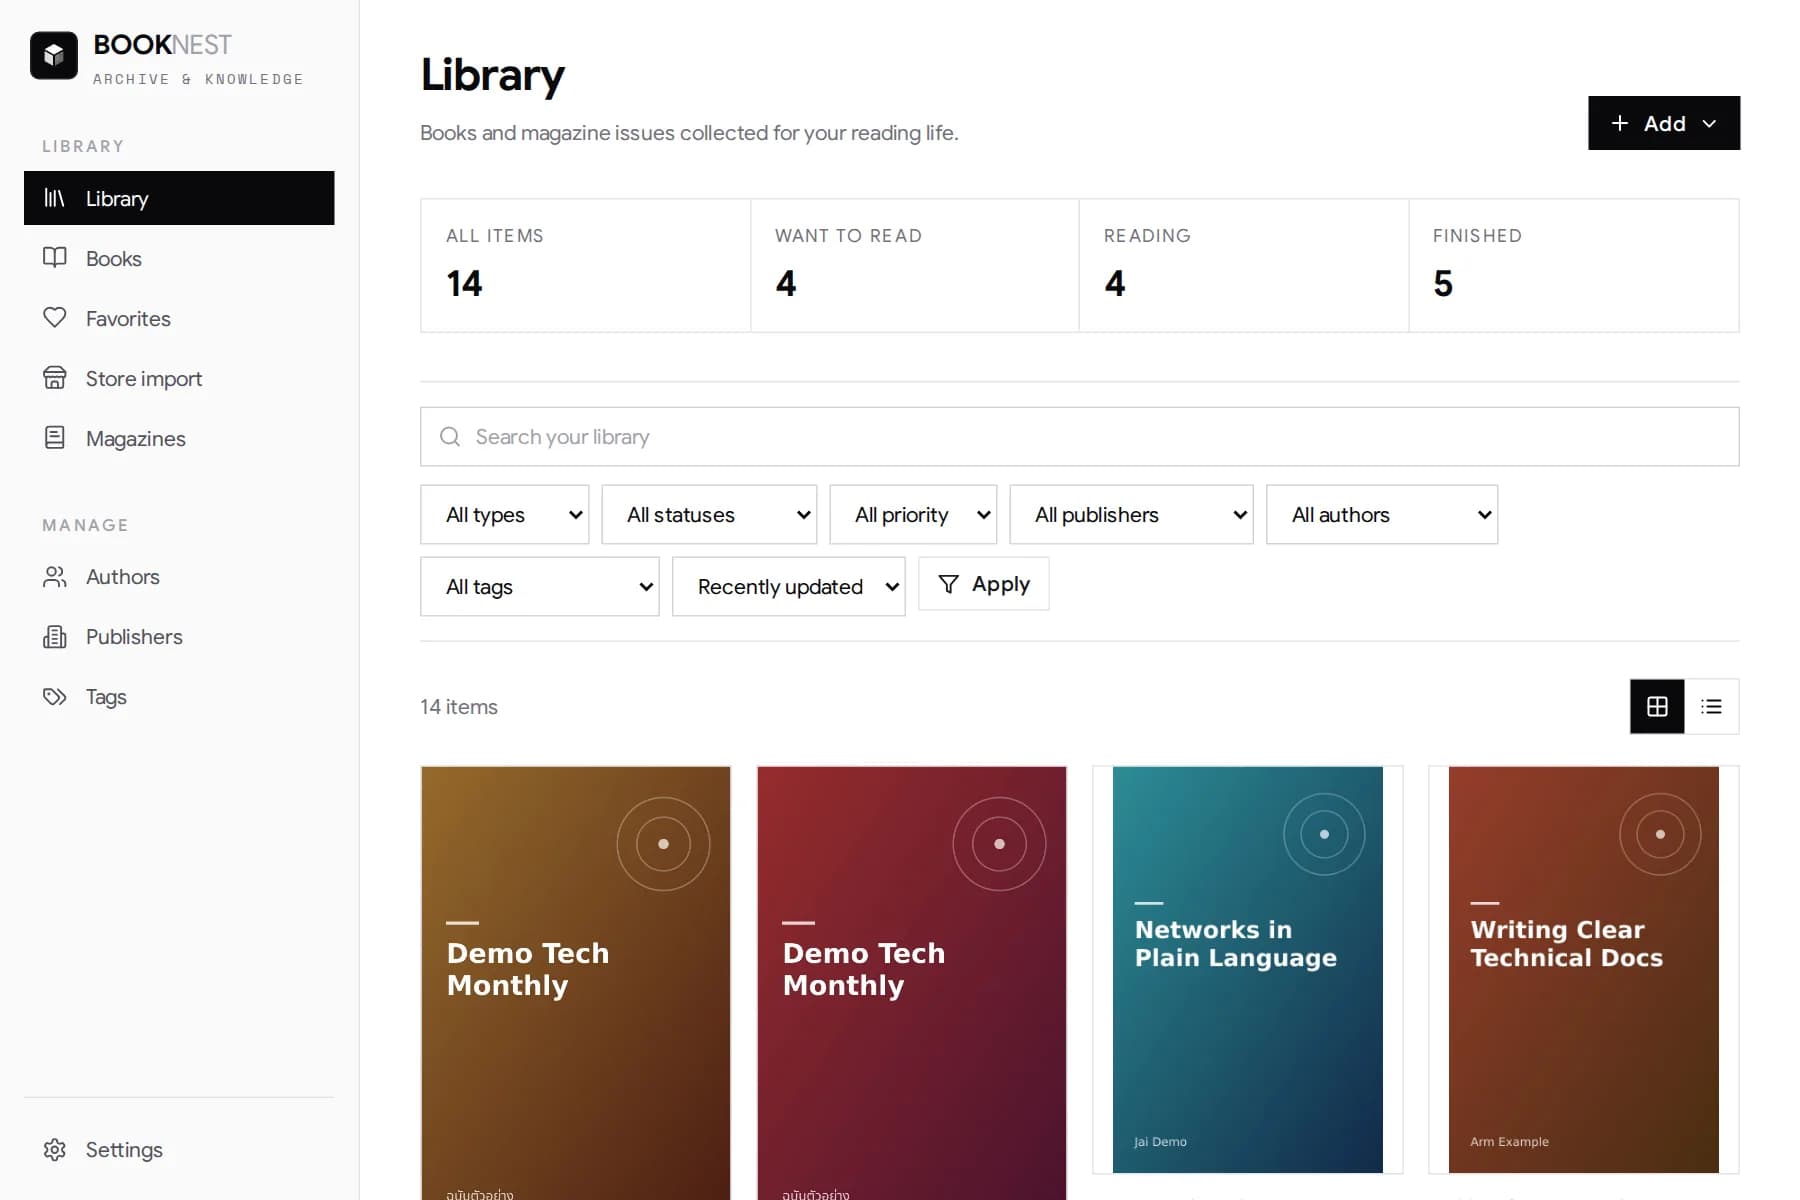
ห้องสมุด (ข้อมูลตัวอย่าง): หนังสือและนิตยสารในที่เดียว นับตามสถานะ Want to read, Reading, Finished กรองตามประเภท สถานะ ความสำคัญ สำนักพิมพ์ ผู้แต่ง และแท็ก
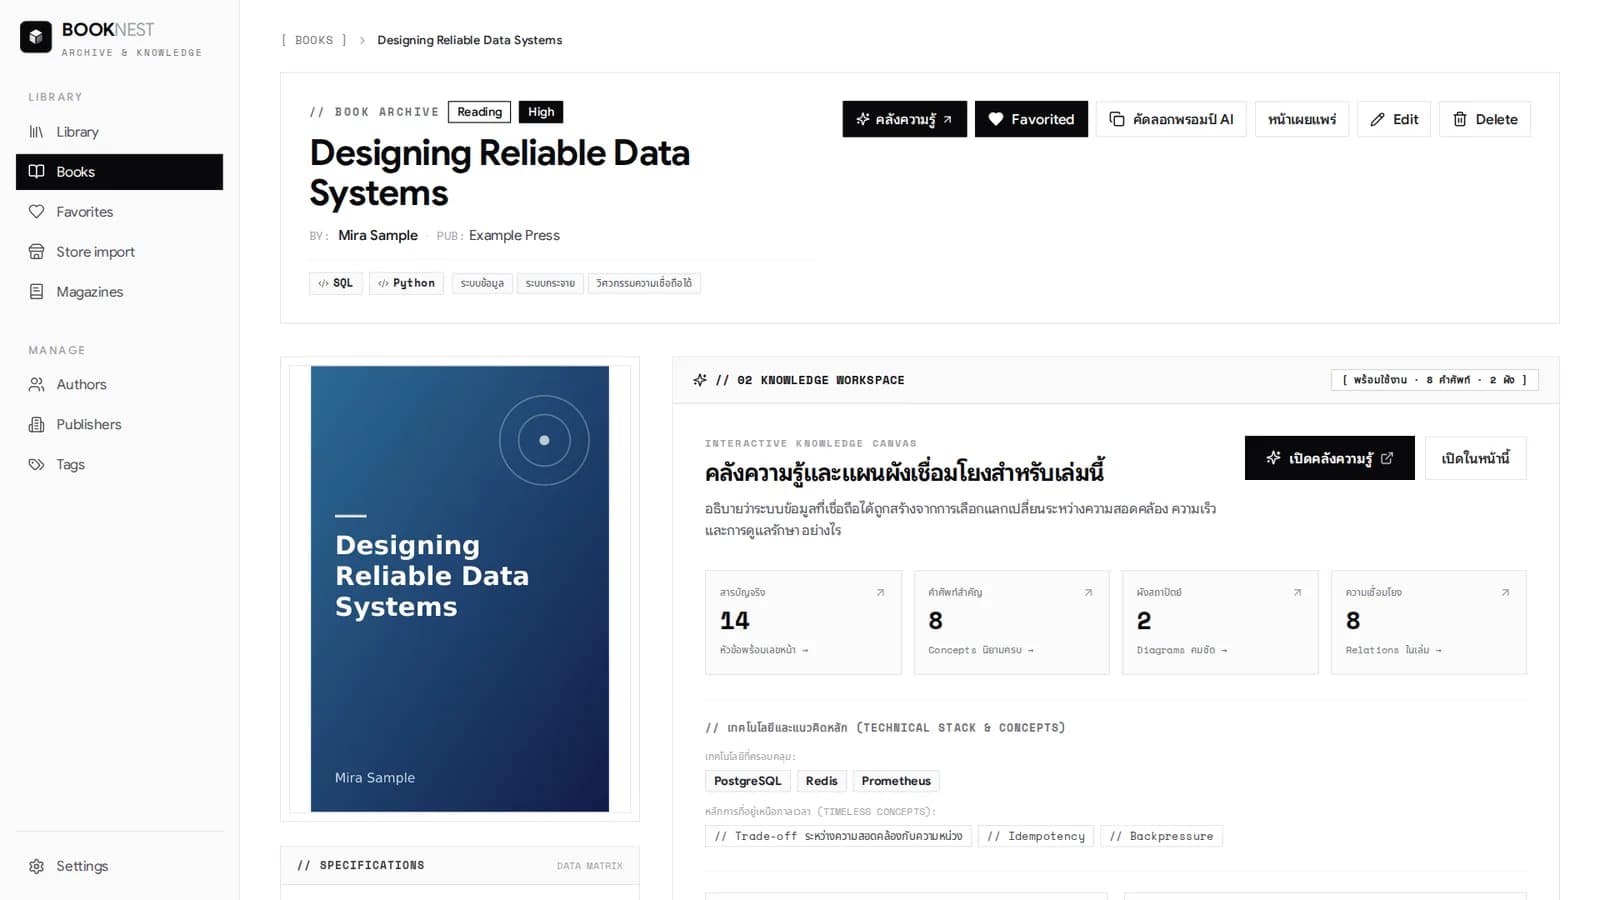
หน้าหนังสือ: ข้อมูลเล่ม แท็ก ปุ่มคลังความรู้ คัดลอกพรอมป์ AI และหน้าแชร์ พร้อมสรุปจำนวนสารบัญ คำศัพท์ ผัง และความเชื่อมโยง
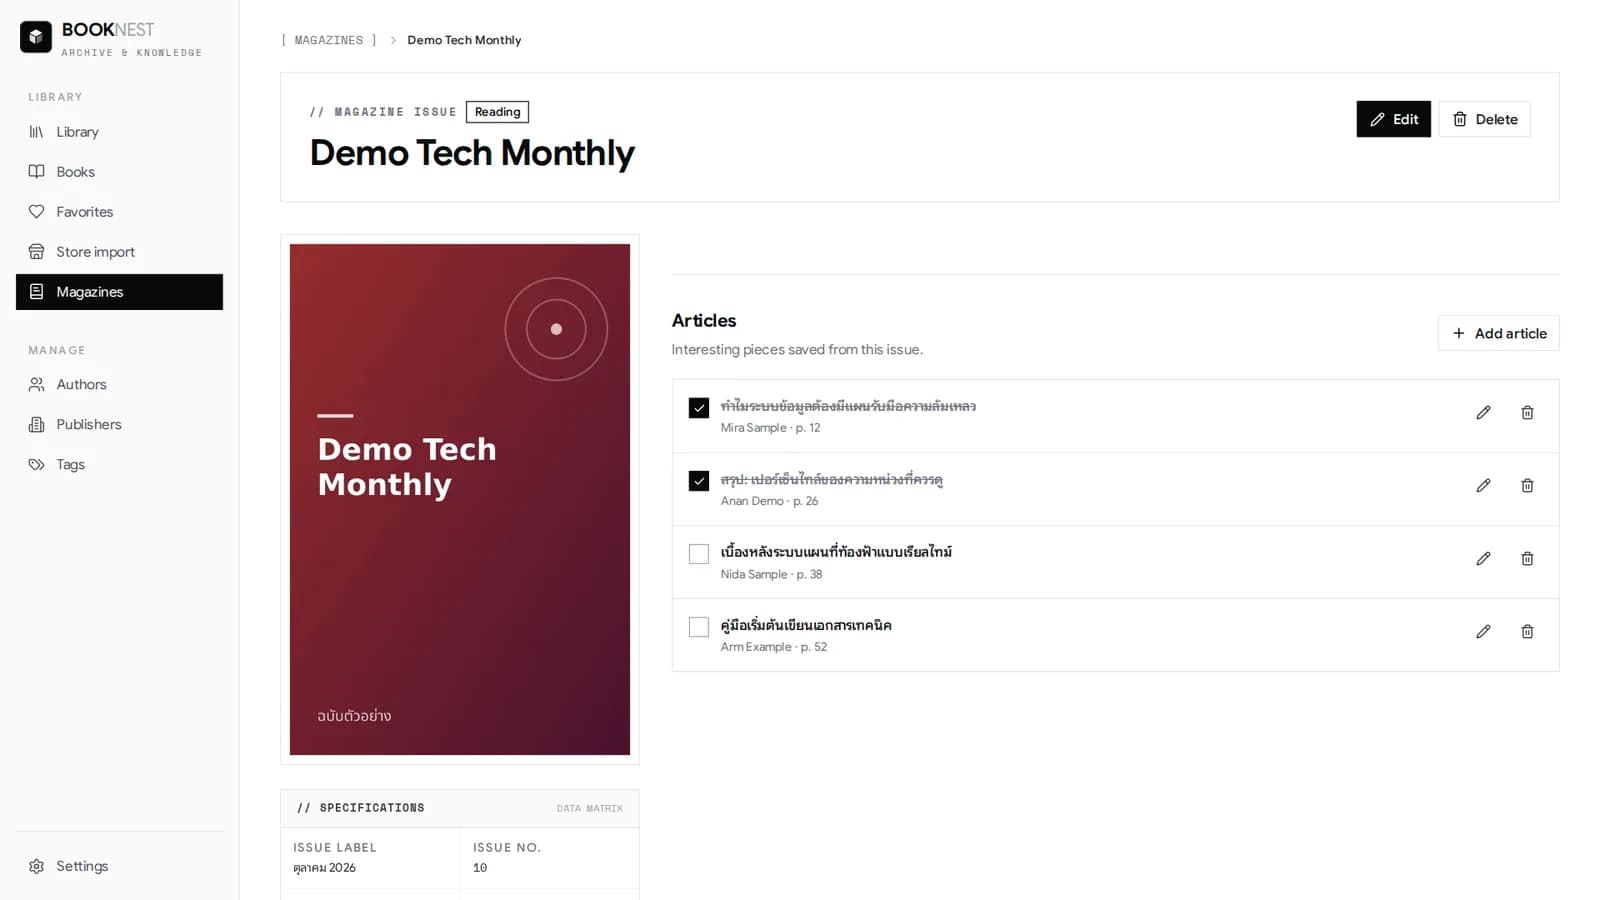
ฉบับนิตยสาร: บันทึกบทความรายชิ้นพร้อมหน้า ผู้เขียน และสถานะอ่านแล้ว
ทบทวนโปรเจกต์
ความท้าทาย
- แยก “สารบัญจริง” ออกจาก “แผนที่เนื้อหาที่ AI สังเคราะห์” ให้เห็นชัดทั้งในโมเดลข้อมูล ตัวตรวจ และหน้าจอ ไม่เช่นนั้นผู้อ่านจะเชื่อสิ่งที่ AI เดา
- ผังที่มาจาก AI อาจมี cycle เส้นซ้ำ ป้ายยาวมาก หรือโหนดโดดเดี่ยว จึงต้องมีฟิกซ์เจอร์ทดสอบเลย์เอาต์และตรวจในเบราว์เซอร์จริง และย้ายการคำนวณ ELK ไปไว้ใน Web Worker
- ออกแบบ schema JSON ให้ผ่านทั้งหนังสือที่มี Part/Division และหนังสือที่บทอยู่ที่ราก และยังรองรับการแก้ไข (revision) โดยไม่ทำให้อ้างอิงเดิมพัง
- ปรับสารบัญแบบ Markdown เดิม (ลบแล้วสร้างใหม่ทุกครั้งที่บันทึก ทำให้ ID ไม่คงที่) ไปเป็นเอกสาร JSON เวอร์ชัน ผ่าน migration ที่ลบตารางสารบัญเก่าโดยไม่ทำลายหนังสือ
สิ่งที่เรียนรู้
- ข้อกำหนดโครงสร้างข้อมูลที่ตรวจได้ (Zod + กติกาข้ามฟิลด์) ทำให้ใช้ AI เป็นผู้ช่วยค้นคว้าได้โดยยังควบคุมคุณภาพ เพราะข้อมูลที่ไม่ผ่านจะไม่ถูกบันทึก
- ป้ายสถานะของข้อความ (ตรวจแล้ว / สังเคราะห์ / ไม่ทราบ) ช่วยให้ข้อมูลที่ไม่แน่นอนยังมีประโยชน์ โดยไม่ทำให้ดูเหมือนข้อเท็จจริง
- การให้ส่วนขยายเบราว์เซอร์ส่งเฉพาะฟิลด์ที่จำเป็นไปยังแอปในเครื่อง ช่วยลดสิทธิ์ที่ต้องขอและความเสี่ยงด้านความเป็นส่วนตัว
สนใจงานแนวนี้?
เล่าโจทย์ของคุณให้ผมฟัง ตอบกลับภายใน 24 ชั่วโมง