โปรเจกต์ส่วนตัว·2026·Web App · Data Visualization · Open Data
Catadex — ไดเรกทอรีแค็ตตาล็อกเฉพาะทาง
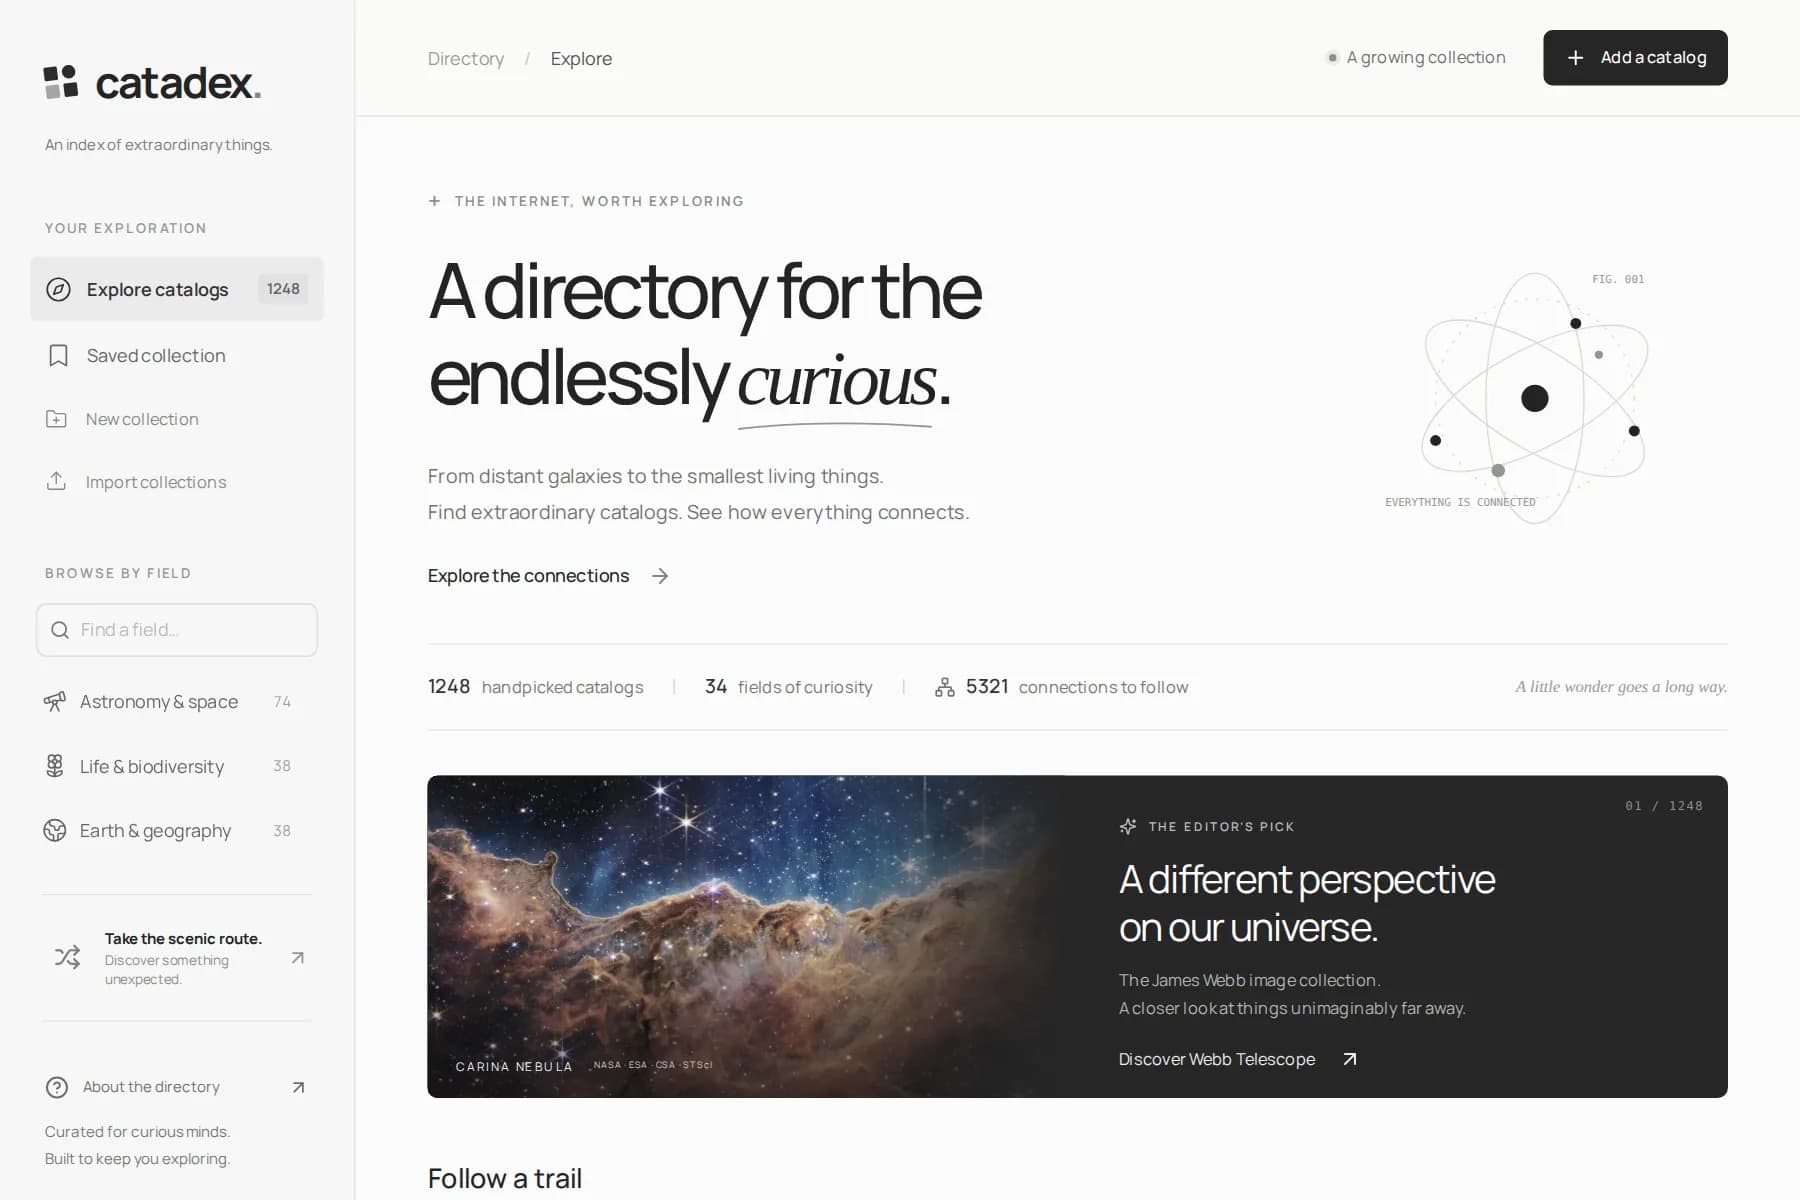
รวมคลังข้อมูลเฉพาะทาง 1,248 แห่งใน 34 หมวด สำรวจผ่านการ์ด ผังความสัมพันธ์ เส้นทางเรียนรู้ และค้นหาได้ทั้งไทยและอังกฤษ
- บทบาท
- นักพัฒนาเดี่ยว — โมเดลข้อมูล คัดและตรวจข้อมูล ระบบค้นหา กราฟ API และการทดสอบ
- ทีม
- งานเดี่ยว
- ระยะเวลา
- 1–4 ต.ค. 2026
- ปี
- 2026
ตัวเลขสำคัญ
- 1,248
- แค็ตตาล็อก
- 34
- หมวดความรู้
- 679
- หัวข้อ
- 5,321
- ความเชื่อมโยงในกราฟ
- 329
- กลุ่มคำพ้องไทย–อังกฤษ
- 9
- เส้นทางเรียนรู้
- 62
- automated tests ที่ผ่าน
Catadex เป็นเว็บรวม “แค็ตตาล็อก” เฉพาะทาง เช่น ฐานข้อมูลดาราศาสตร์ ชนิดพันธุ์ แร่ แผนที่เก่า และคลังเสียง ทุกรายการมีภาพปก คำอธิบายภาษาไทย แท็ก และลิงก์ไปยังเว็บต้นทาง สำรวจได้ทั้งแบบการ์ดและกราฟความสัมพันธ์ (Cytoscape.js) ที่เชื่อมแค็ตตาล็อกเข้ากับหมวด หัวข้อ โดเมนเดียวกัน และข้อมูลที่ซ้อนทับกันอย่างมีหลักฐาน ระบบค้นหาเข้าใจไทย–อังกฤษข้ามกัน มีตรวจสถานะลิงก์อัตโนมัติ คอลเลกชันส่วนตัว เส้นทางเรียนรู้ และ API สาธารณะแบบอ่านอย่างเดียว ข้อมูลเริ่มต้น 1,248 รายการ 679 หัวข้อ 5,321 ความเชื่อมโยง ผมคัดและตรวจเอง และไม่อ้างว่าครอบคลุมทุกเว็บไซต์
โจทย์และปัญหา
- 01แหล่งข้อมูลเฉพาะทางที่ดีมากมีอยู่ทั่วเว็บแต่หายาก และรายการที่รวบรวมไว้มักเป็นลิสต์เรียบ ๆ ที่ไม่บอกว่าเว็บไหนเกี่ยวกับเว็บไหน
- 02ผู้ใช้ไทยค้นด้วยคำไทย แต่เว็บส่วนใหญ่ชื่อและแท็กเป็นอังกฤษ การค้นแบบตรงตัวจึงไม่พบ
- 03ลิงก์เสียได้ตลอดเวลา และบางเว็บบล็อกบอตจนตรวจไม่ได้ ถ้าตัดสินว่าเสียเร็วเกินไปก็ซ่อนรายการดีไปโดยไม่ควร
- 04การให้ผู้ใช้เพิ่มรายการด้วย URL หมายถึงเซิร์ฟเวอร์ต้องไปดึงหน้าเว็บอื่น ซึ่งเสี่ยง SSRF และการใช้ทรัพยากรเกินควร
วิธีแก้
- 01ข้อมูล 6 ตาราง (Category, Catalog, Tag, CatalogTag, GraphNode, GraphEdge) บน SQLite แต่ละโหนดแทน Catalog, Category หรือ Tag เพียงอย่างเดียวและมี CHECK constraint บังคับความสอดคล้อง เส้นเชื่อม 4 ชนิด: RELATED_FIELD, SHARED_TOPIC, SHARED_DOMAIN และ DATA_OVERLAP ซึ่งต้องมี URL หลักฐาน — ไม่อนุมานการซ้อนทับของข้อมูลจากการอยู่หมวดเดียวกัน
- 02ค้นหาจัดอันดับตามความตรง (ชื่อ > แท็ก > โดเมน > คำอธิบาย) เข้าใจไทย–อังกฤษข้ามกันด้วยพจนานุกรมคำพ้อง 329 กลุ่ม ตัดคำไทยที่พิมพ์ติดกัน ไฮไลต์คำที่ตรง เสนอคำสะกดที่ถูกเมื่อไม่พบ และแสดงรายการที่ตรงบางคำเมื่อไม่มีรายการใดตรงทุกคำ
- 03ทุกมุมมองอยู่ใน URL (คำค้น หมวด หัวข้อ การเรียง Grid/Graph หมวดของกราฟ และรายการที่เปิด) รีโหลด ส่งต่อ และกด Back ได้ ค่าที่ไม่รู้จักในลิงก์เก่าจะถูกข้ามแทนที่จะเปิดหน้าว่าง ลิงก์ที่แชร์มี preview ตามชื่อ คำอธิบาย และภาพปก
- 04กราฟ: ค้นหาโหนดแล้วซูมไป และ “Find a path” หาเส้นทางระหว่างสองแค็ตตาล็อกผ่านหัวข้อ หมวด โดเมน หรือความสัมพันธ์ของข้อมูลที่มีหลักฐาน (20 ความสัมพันธ์ เช่น PDB, INSDC, OpenStreetMap) หน้าแรกไม่ฝังกราฟ กราฟโหลดจาก /api/graph เมื่อเปิดมุมมองนี้
- 05สถานะลิงก์: ตัวตรวจทำงานเป็นชุดละ 100 ลิงก์ผ่าน GitHub Actions ทุก 3 ชั่วโมง ติดป้าย “Link may be down” หลังล้มเหลวสองครั้งติดกัน เว็บที่ปฏิเสธบอทหรือใบรับรองมีปัญหาจัดเป็น restricted ไม่ใช่เสีย และหน้ารายละเอียดมีวันที่ตรวจพร้อมลิงก์ Wayback Machine
- 06คอลเลกชันส่วนตัวหลายชุดพร้อมโน้ตต่อรายการ ส่งออก/นำเข้า JSON และลิงก์แชร์ที่ฝังรายชื่อไว้ในลิงก์ (โน้ตไม่ถูกแชร์) เส้นทางเรียนรู้ 9 เส้นเรียงลำดับพร้อมคำอธิบายทีละขั้น และบุ๊กมาร์กเก็บใน localStorage ของเบราว์เซอร์
- 07ตัวดึง metadata รับเฉพาะ HTTP/HTTPS บนพอร์ตมาตรฐาน ปฏิเสธ credentials, localhost และ IP ส่วนตัว/สงวน (รวม IPv4 ที่เข้ารหัสและ IPv6 ที่ map IPv4) ตรวจ DNS ทุก redirect ล็อก IP ที่ตรวจแล้วไว้กับ connection เพื่อกัน DNS rebinding จำกัด HTML ที่ 2 MiB, 4 redirect, 10 วินาที ส่วน POST รับ JSON เท่านั้น จำกัด 16 KiB และ 20 คำขอ/นาทีต่อ IP
- 08API สาธารณะแบบอ่านอย่างเดียว (/api/v1/*) ค้น/กรอง/แบ่งหน้า ส่งออก CSV และฟีด Atom ของรายการใหม่ ภาพปกเป็น OG preview ของเว็บเองเมื่อใช้ได้ ไม่เช่นนั้นเป็นภาพที่วาดเฉพาะรายการตามหมวด (สคริปต์ Python) และมีภาพย่อ WebP 480px ที่สร้างด้วย sharp
ผลลัพธ์
- 01ได้ไดเรกทอรีที่เปิดสำรวจได้ 3 ทาง (การ์ด กราฟ และเส้นทางเรียนรู้) โดยทุกมุมมองแชร์เป็นลิงก์เดียวได้
- 02ชุดทดสอบ 62 รายการผ่านทั้งหมด ครอบคลุมการปฏิเสธ URL ภายใน, parser ของ metadata, ค้นหา, view state, เส้นทางในกราฟ, สถานะลิงก์, คอลเลกชัน, API สาธารณะ และข้อมูลที่ seed พร้อม Playwright E2E ในรีโป
- 03ข้อมูลสะท้อนความจริง: ไม่ใช้ตัวเลขที่เปลี่ยนตลอดเวลา (เช่น จำนวนสายพันธุ์) และระบุข้อจำกัดของการตรวจลิงก์ไว้ในเอกสาร ผลตรวจล่าสุดเก็บใน docs/catalog-link-audit.json
สิ่งที่ส่งมอบ
- เว็บ Next.js 16 พร้อมมุมมองการ์ด กราฟ (Cytoscape.js) เส้นทางเรียนรู้ และคอลเลกชัน
- โมเดล Prisma + SQLite พร้อม migration และ seed แบบ idempotent (1,248 แค็ตตาล็อก)
- ระบบค้นหาไทย–อังกฤษ ตัวกรองการเข้าถึง และ API สาธารณะ /api/v1 พร้อมส่งออก CSV และฟีด Atom
- ตัวตรวจสถานะลิงก์ (สคริปต์ + GitHub Actions) และตัวดึง metadata ที่ปลอดภัย
- สคริปต์สร้างภาพปกและภาพย่อ (Python, sharp) พร้อมเอกสารที่มาของภาพ (ASSETS.md)
- ชุดทดสอบ node:test 62 รายการ และ Playwright E2E
แกลเลอรี
ค้นหา กรอง และเรียกดู
16:9 / LG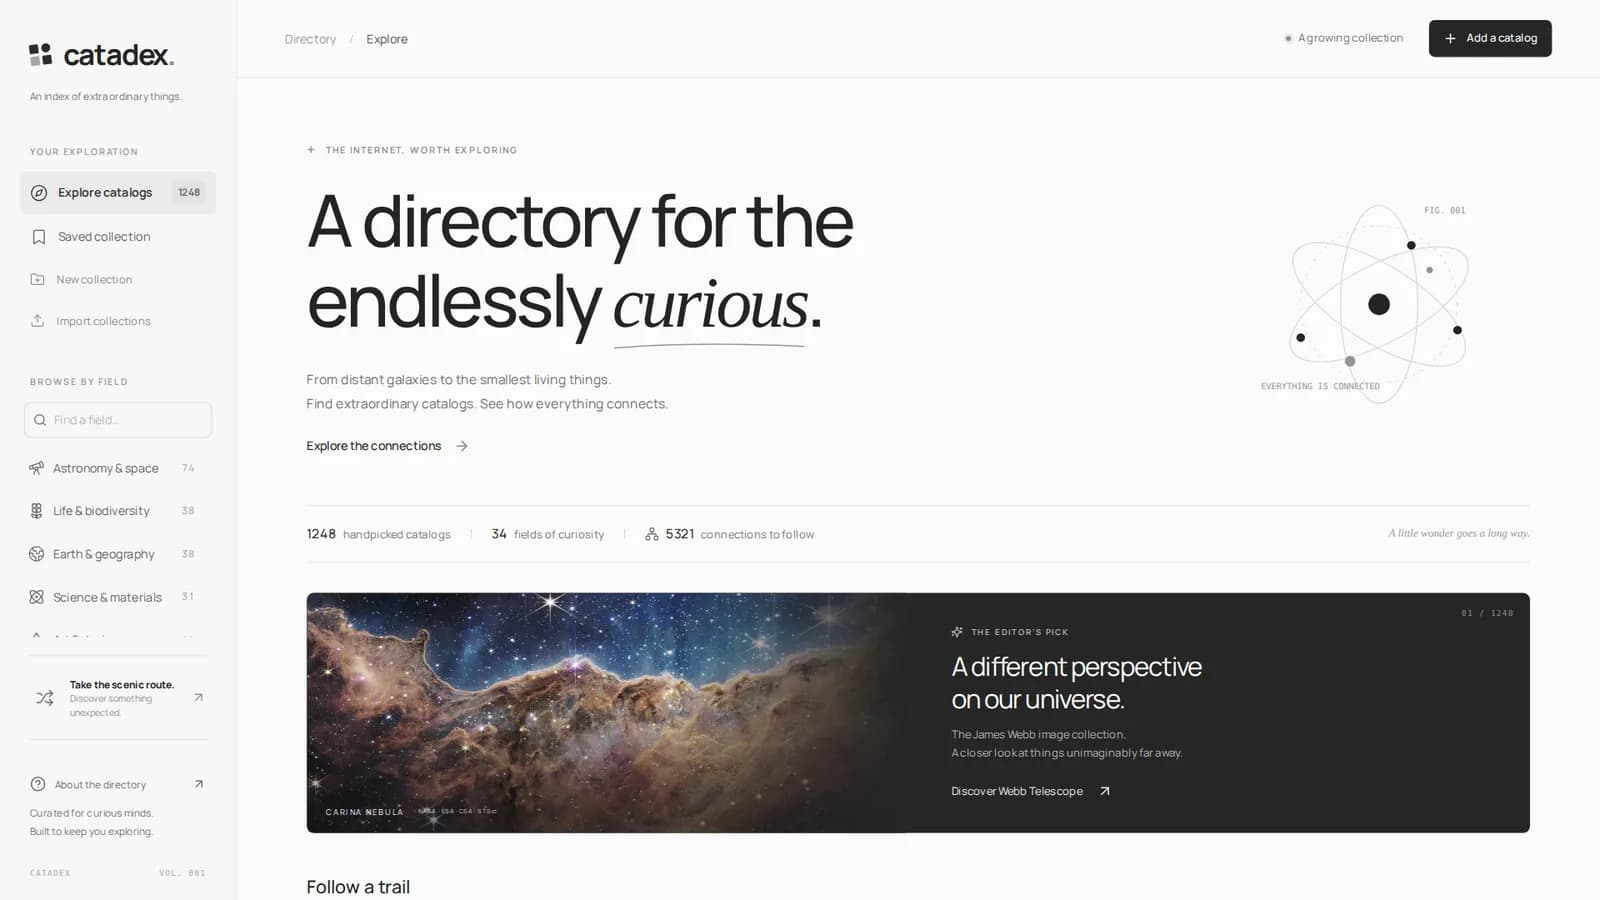
หน้าแรก: ไดเรกทอรีแค็ตตาล็อกเฉพาะทาง 1,248 รายการใน 34 หมวด พร้อมความเชื่อมโยง 5,321 เส้น และรายการแนะนำประจำหน้า
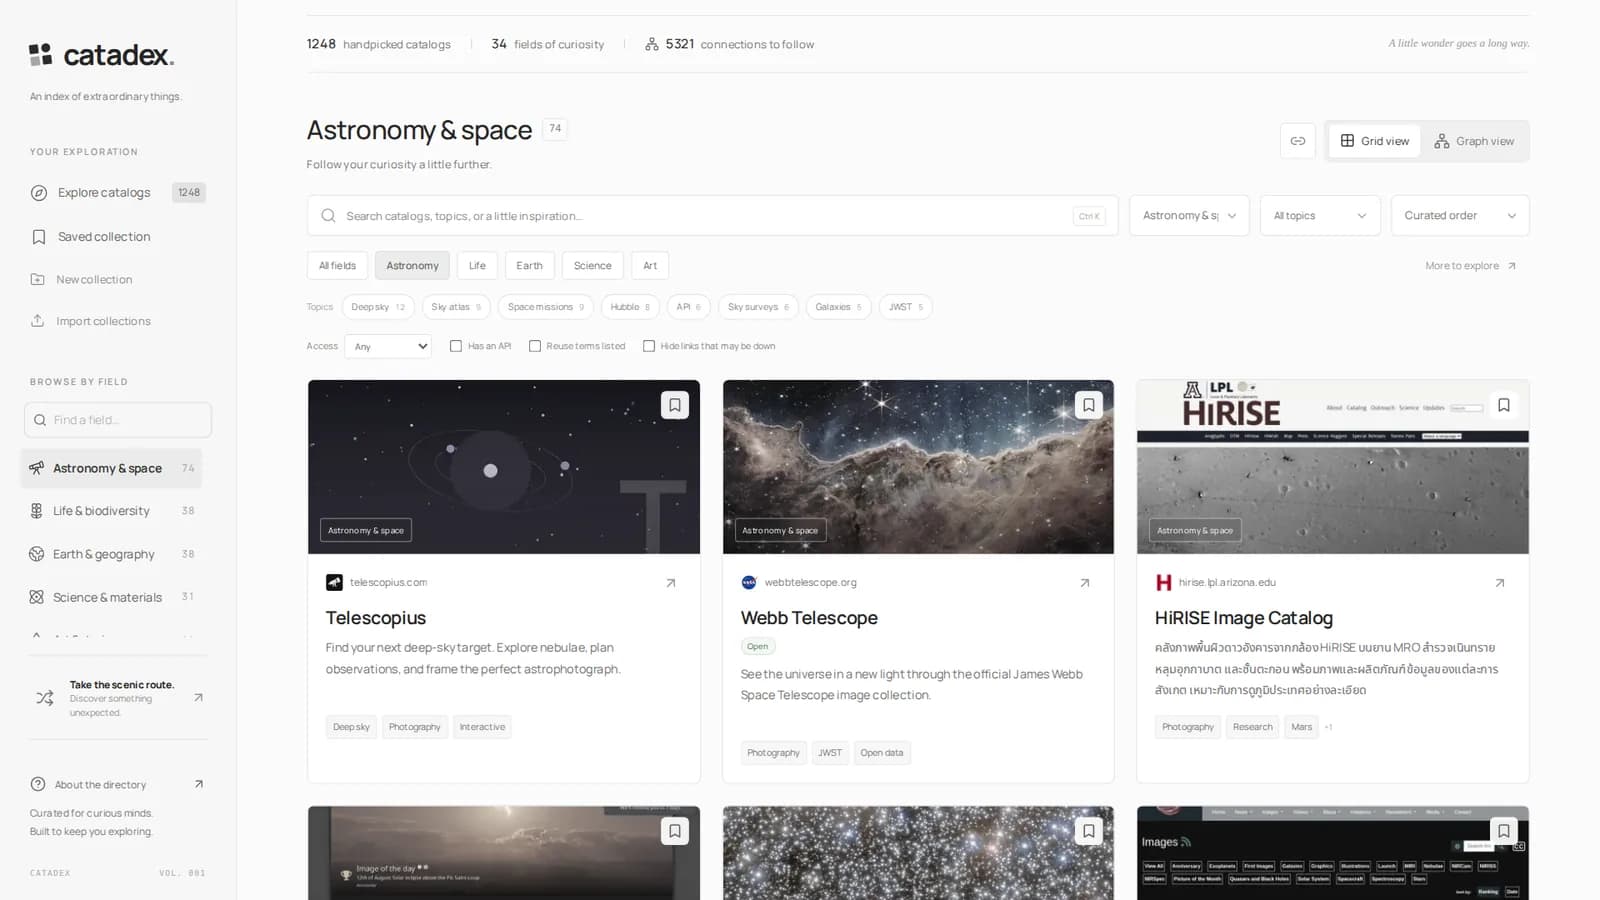
กรองตามหมวด Astronomy & space (74 รายการ) การ์ดแสดงภาพปก โดเมน คำอธิบาย และแท็ก พร้อมตัวกรองหัวข้อ ระดับการเข้าถึง และ “มี API”
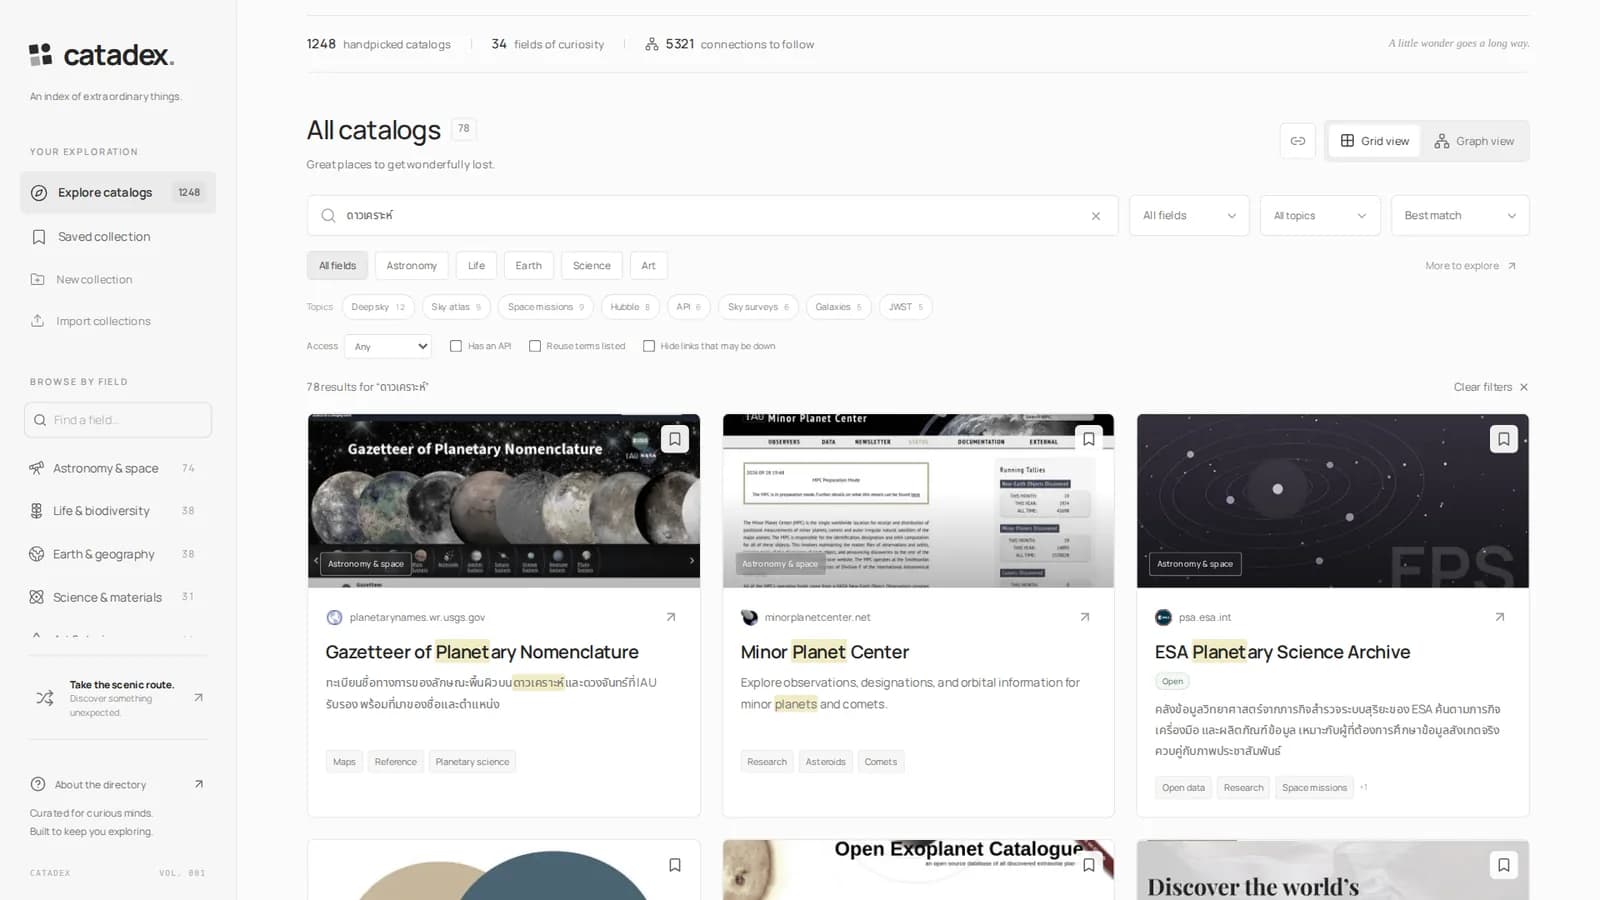
ค้นหาภาษาไทย “ดาวเคราะห์” ได้ 78 รายการผ่านพจนานุกรมคำพ้องไทย–อังกฤษ 329 กลุ่ม พร้อมไฮไลต์คำที่ตรง
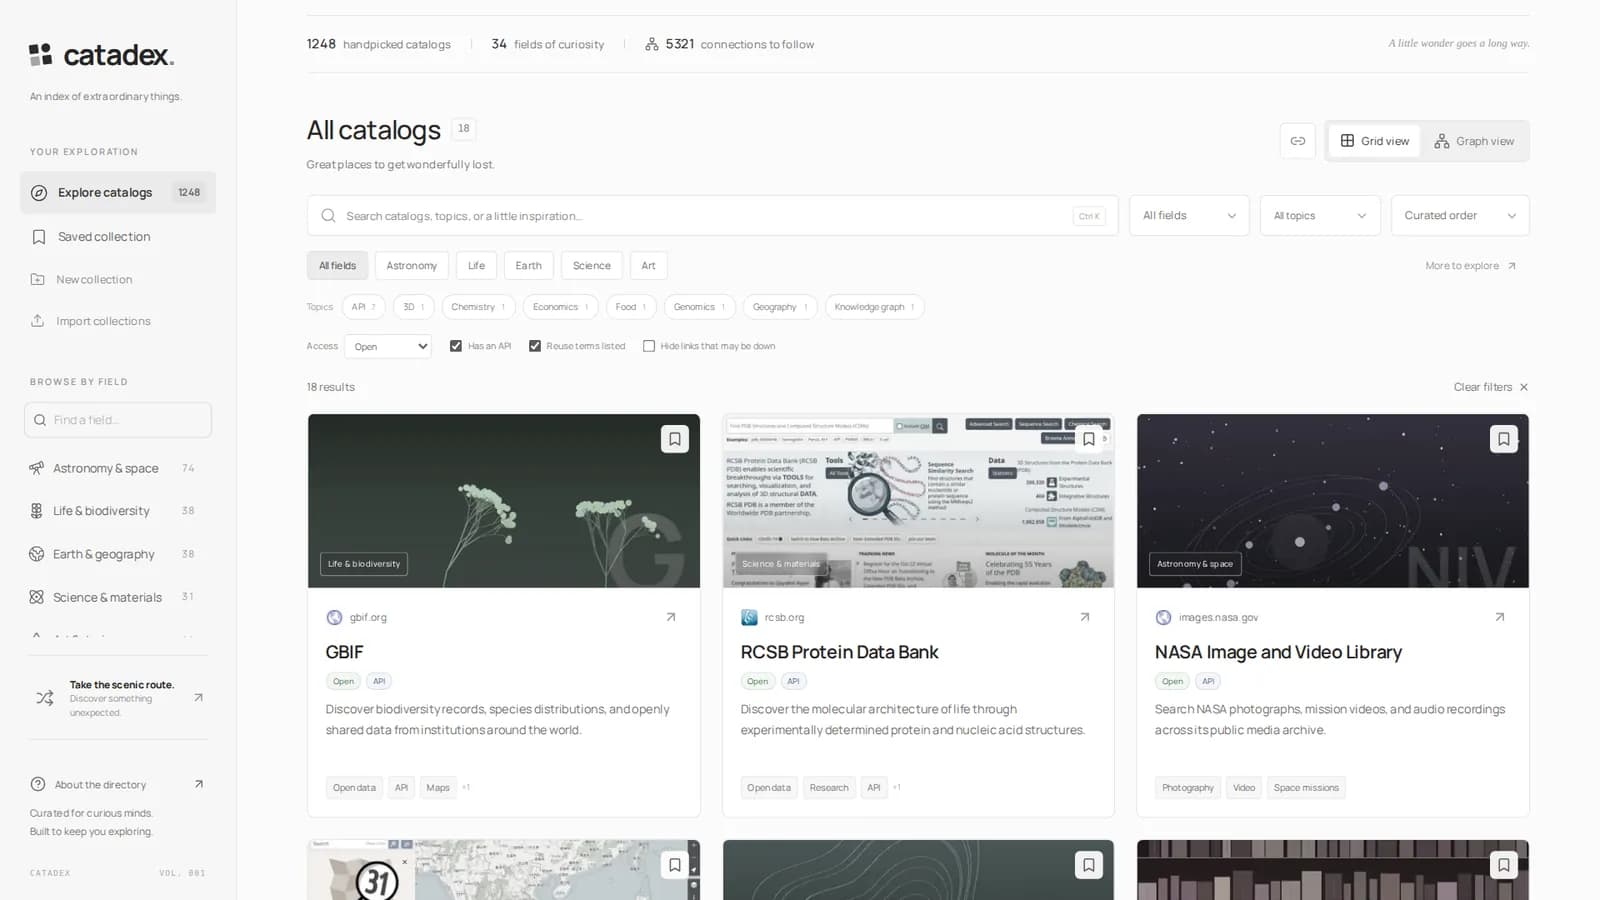
ตัวกรองการเข้าถึง: Open ร่วมกับ “มี API” และ “ระบุเงื่อนไขการนำไปใช้ซ้ำ” ค่า access มาจากแท็กหรือบันทึกที่ผมตรวจเอง และรายการที่ไม่ทราบจะไม่ถูกจับคู่
ทบทวนโปรเจกต์
ความท้าทาย
- ค้นหาไทย–อังกฤษโดยไม่มีบริการภายนอก: ต้องสร้างพจนานุกรมคำพ้องเอง ตัดคำไทยแบบเบา ๆ และจัดอันดับให้ชื่อตรงมีน้ำหนักมากกว่าคำอธิบาย
- แยก “เว็บที่เสีย” ออกจาก “เว็บที่ไม่ให้บอตเข้า” ต้องมีสถานะ restricted และเกณฑ์ล้มเหลวสองครั้งติดกัน ไม่เช่นนั้นจะติดป้ายผิด
- ผังที่มีแค็ตตาล็อกพันกว่ารายการอ่านยาก จึงวางหมวดเป็นวงรี ให้หัวข้อที่ใช้ร่วมอยู่กลาง ปรับขนาดตัวอักษรตามระดับซูม และให้กรองเป็นรายหมวดได้
- รักษา ID ของรายการให้คงเดิมเมื่อ seed ซ้ำ เพื่อให้บุ๊กมาร์กของผู้ใช้ไม่หาย และให้ seed รันซ้ำได้โดยไม่สร้างรายการซ้ำ
สิ่งที่เรียนรู้
- การเก็บสถานะมุมมองไว้ใน URL ทำให้ทั้งแชร์ ย้อนกลับ และทดสอบง่ายขึ้นมาก
- ข้อมูลคัดสรรต้องบอกขอบเขตของตัวเองตรง ๆ (ไม่อ้างว่าครบ ไม่อ้างความสัมพันธ์ที่ไม่มีหลักฐาน) จึงจะน่าเชื่อถือ
- ตัวดึงข้อมูลจากภายนอกต้องออกแบบแบบป้องกันตั้งแต่แรก (ตรวจ IP ล็อกค่า จำกัดขนาด เวลา และอัตรา) ไม่ใช่เติมทีหลัง
สนใจงานแนวนี้?
เล่าโจทย์ของคุณให้ผมฟัง ตอบกลับภายใน 24 ชั่วโมง